十分钟在带 GPU 的 Amazon EC2 上部署 Ollama 服务
适合个人或小团队在云上自建开源大模型服务的一份指南:选带 GPU 的实例和预装驱动的 AMI,安装 Ollama,跑 llama2,用 Nginx 做反向代理对外提供服务,再用 open-webui 做个界面。
English version: How to Deploy Ollama Server on Amazon EC2 with GPU in 10 Minutes
这是一份在带 GPU 的 Amazon EC2 实例上部署 Ollama 服务的完整指南,十分钟能做完。
适合个人或小团队在云上搭建自己的开源本地大语言模型(LLM)能力:数据私有、可定制、合规,而且成本可控。
下面一步一步走,附上详细的操作和参考。
大模型与 Ollama
要把一个大语言模型部署起来对外提供服务,不仅需要高端 GPU,还需要相当多的技术知识,所以很多人只能依赖大公司的 API 服务,比如 OpenAI 的 GPT 或者 Google 的模型。
但开源项目 llama.cpp 通过 CPU 优化和简化部署方式,实现了 AI 的“平民化”。个人开发者或小团队也能在云上部署自己的 AI 服务。
Ollama 是基于 llama.cpp 的项目,提供了更友好的 API,可以直接通过 HTTP 请求调用 AI 服务。它支持 macOS、Linux、Windows 和云端部署,也支持 GPU 加速。
在 EC2 上部署 Ollama
第一步:创建 EC2 实例
下面是一个带 GPU 加速的 EC2 实例配置。Ollama 也支持纯 CPU 运行,但推理会慢很多,所以选带 GPU 的实例。
注意:申请创建 G 系列实例后,可能会收到 AWS 的创建失败通知,要求先申请配额。通知里有链接,申请大约要半天,通过后再创建一次。
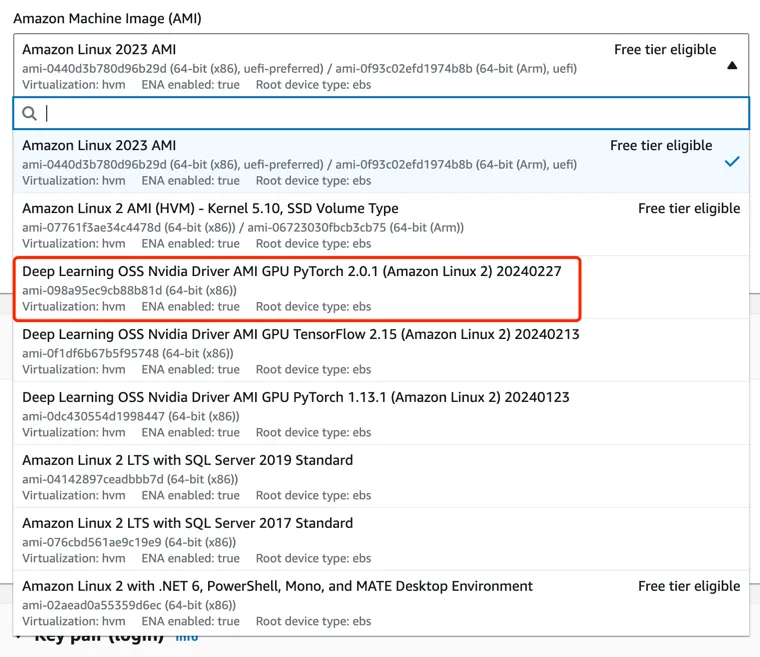
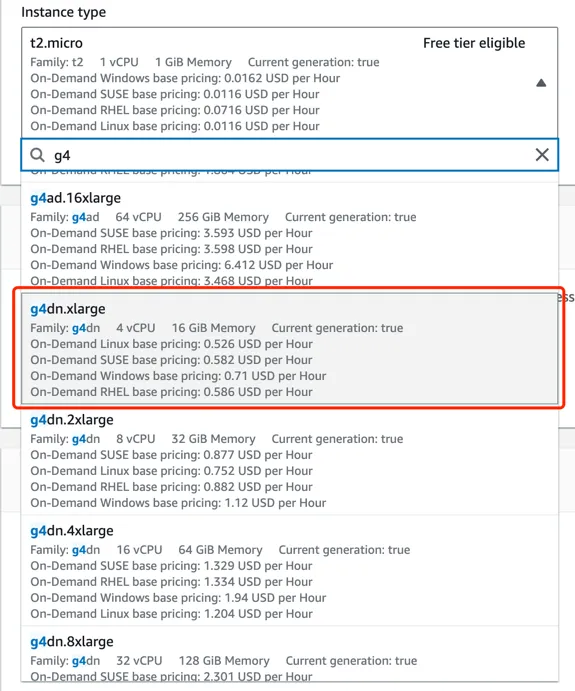
配置一台 Amazon Linux 2 的 EC2 实例:
- AMI:Deep Learning OSS Nvidia Driver AMI GPU PyTorch 2.0.1 (Amazon Linux 2) 20240227
- 实例类型:g4dn.xlarge(约 380 美元/月,见 https://calculator.aws)
- vCPU:4
- 内存:16GB
- EBS:50GB(gp3)
第二步:安装 Ollama
用 ssh 登录 EC2 实例,然后执行安装命令。
ssh -i "Key1.pem" ec2-user@ec2-3-228-24-35.compute-1.amazonaws.com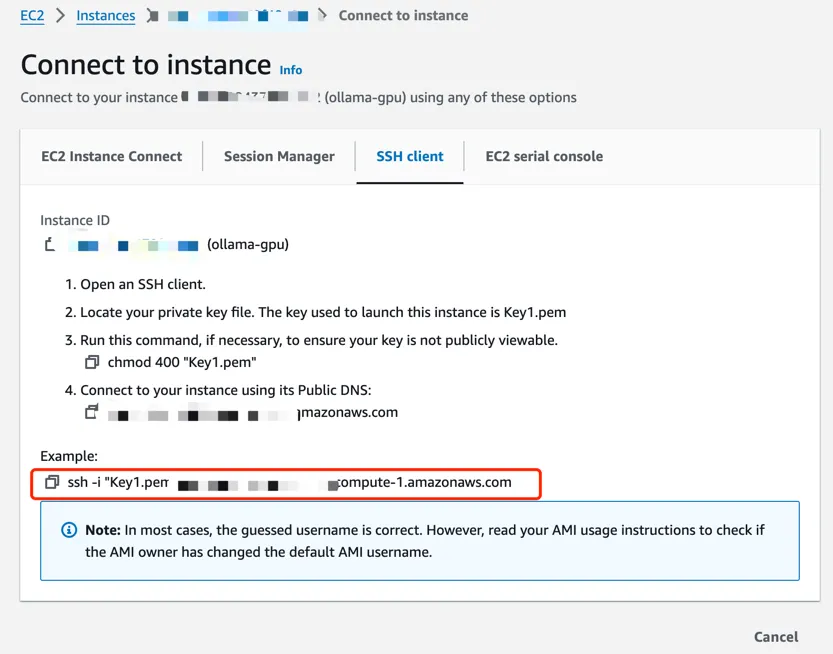
先检查 Nvidia 驱动是否安装成功:
nvidia-smi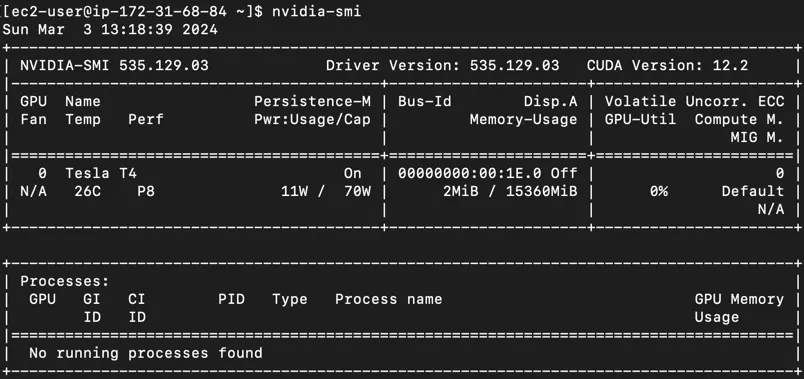
安装 Ollama 并检查服务状态。如图,日志里出现 Nvidia GPU Detected 就说明 Ollama 已经识别到了 GPU。
curl -fsSL https://ollama.com/install.sh | sh
sudo systemctl status ollama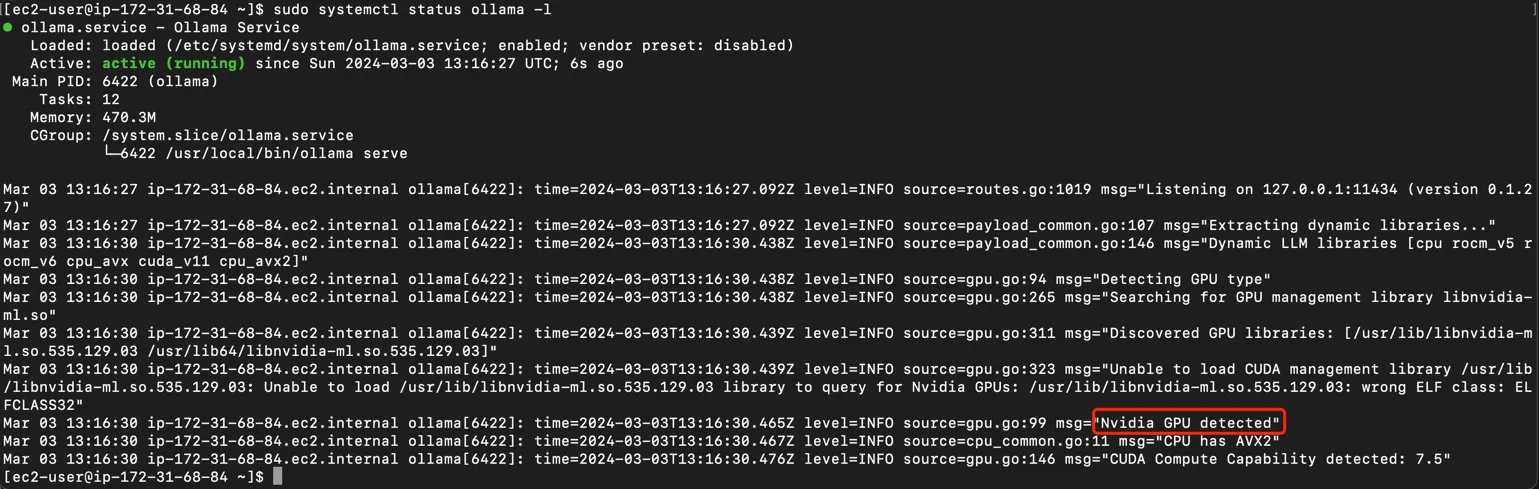
第三步:跑一个 llama2 模型
装好 Ollama 之后,跑一个 llama2 模型,测试服务是否正常、GPU 加速有没有生效。
ollama run llama2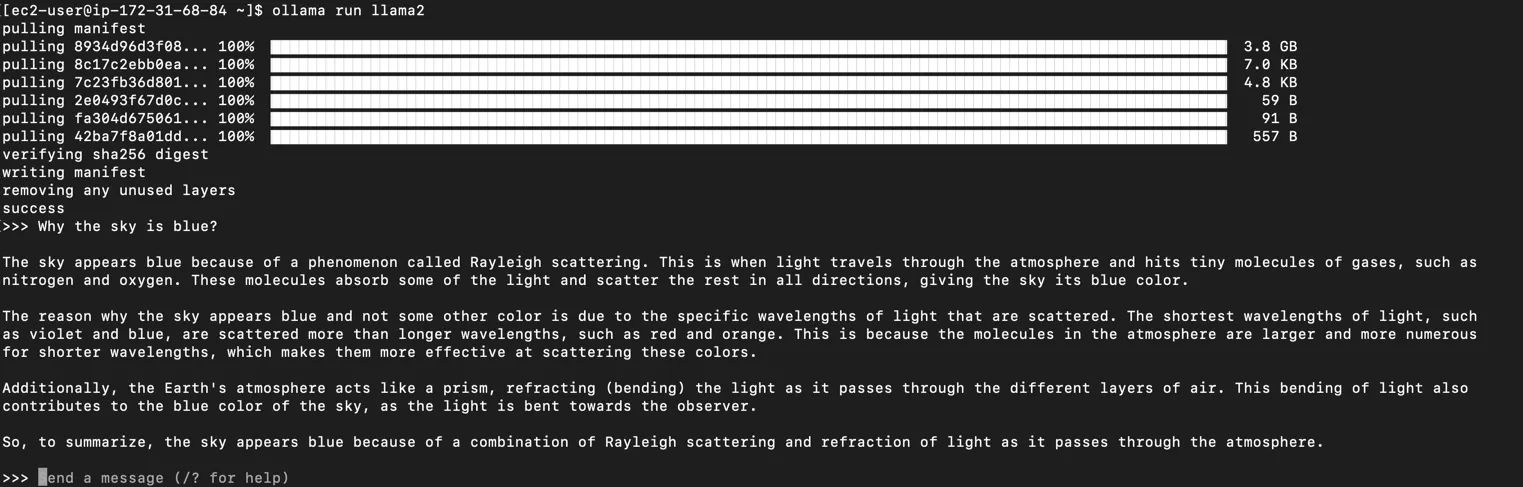
第四步:安装和配置 Nginx
接下来装 Nginx 做反向代理,把 80 端口的请求转发到 11434 端口,对外提供服务。
sudo amazon-linux-extras install nginx1sudo vim /etc/nginx/conf.d/myapp.confserver {
listen 80;
location / {
proxy_pass http://127.0.0.1:11434;
proxy_set_header Host $host;
proxy_set_header X-Real-IP $remote_addr;
proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
proxy_set_header X-Forwarded-Proto $scheme;
}
}重启 Nginx 让配置生效:
sudo systemctl restart nginx第五步:部署 open-webui
open-webui 是一个开源前端项目,给 Ollama 服务提供一个友好的界面。
我们在本地用 docker 快速跑一个 open-webui,指定 Ollama 的地址来测试效果。确保本地已装 docker,然后执行下面的命令。
把 https://x.x.x.x/api 里的 x.x.x.x 换成你 EC2 实例的公网 IP:
docker run -d -p 3000:8080 -e OLLAMA_API_BASE_URL=https://x.x.x.x/api -v open-webui:/app/backend/data --name open-webui --restart always ghcr.io/open-webui/open-webui:main总结
在 AWS EC2 上快速部署带 GPU 的 Ollama 服务,最关键的一点是 AWS 提供了预配置的 AMI:Deep Learning OSS Nvidia Driver AMI GPU PyTorch 2.0.1 (Amazon Linux 2) 20240227。它预装了 Nvidia 驱动,省掉了大量安装配置时间,和 Ollama 几乎是开箱即用。
另一个关键点是 Nginx 的配置。通过反向代理可以把 Ollama 服务对外提供,还可以在 Nginx 层做负载均衡、限流,以后再加身份认证、日志等功能。