量化选股学习笔记(十):管理层的话,市场两天就读完了
财报里的数字之外,新闻稿里管理层的用词有没有额外的信息?用 SEC 免费的 10 万份财报新闻稿和金融情绪词典测下来:文字确实是新闻,而且几乎和数字无关,但两天内就被价格吸收,之后没有漂移。顺带发现,新闻稿里约五分之一是律师写的,而且一年比一年多。
这是我学习量化选股的第十篇笔记。上一篇测了分析师评级变动,结果失败:评级变动是新闻,但两天就被吸收了。上一篇结尾说下一步是模拟盘;市值的错误已经修好(第四到第八篇的数字和图都已更新),但在做模拟盘之前,我想再试一个新信号:财报新闻稿的语气。代码仍然由 Claude Code 编写,我负责提问、读代码和决定方向。
本文是学习记录,不构成任何投资建议。
为什么选新闻稿
第八篇的 SUE 用的是财报里的数字:EPS 比分析师预期高了多少。可公司发财报时,除了数字还有一整篇新闻稿:标题、要点、CEO 的引语、对下个季度的展望。同样是“超预期 5%”,一家公司说“创纪录的季度”,另一家说“面对挑战性的环境”,读者的感受完全不同。
学界对这件事有两种相反的发现:
- 乐观的语气是好消息:Davis、Piger、Sedor(2012)发现,新闻稿越乐观,公司之后的业绩越好,市场也会正面反应。
- “语气管理”:Huang、Teoh、Zhang(2014)发现,如果语气明显比数字支持的更乐观,之后的业绩和股价反而更差,因为管理层在粉饰。
所以要回答两个问题:语气里有没有数字之外的信息?如果有,市场是当场就消化,还是之后几个月还会慢慢反映?只有后一种才能做成月度调仓的选股信号。
数据是免费的。美国公司发财报时,要向 SEC 提交一份 8-K 表格(第 2.02 项“经营业绩”),新闻稿就是它的附件 99.1。SEC 的 EDGAR 系统允许每秒 10 次请求,我们用每秒 8 次,一共 20 万次请求,下载了 4,838 家公司从 2020 年 6 月起的 100,036 份财报 8-K,只保留文字,表格去掉。
第一课:先检查数据
和之前每一篇一样,先检查再用:
- 覆盖率够:87% 的公司-月份在过去 120 天内有一份新闻稿,大公司是 98%,和 SUE 差不多。从来不发的 530 家公司里,43 家是外国公司(它们用 6-K),410 家是微型股。
- 日期对得上:81% 和第八篇的财报公告日是同一天提交的。
- 大部分在收盘后发:59% 在下午 4 点以后提交,市场第二天才读到。所以信号沿用第八篇的规则:公告后第二个交易日收盘以后才算“知道”。
- 12% 不是季度财报:初步业绩、更正、在行业会议上的发言,也会用同一个第 2.02 项提交。这些去掉,每次财报只留一份新闻稿。
第二课:新闻稿的五分之一是律师写的
打开几份新闻稿就会发现,结尾总有大段的“前瞻性声明”和“safe harbor”:本新闻稿包含前瞻性陈述,实际结果可能因为以下风险而有重大差异……后面跟着一长串 risk、uncertain、failure、litigation。还有非 GAAP 指标的定义、电话会议的拨号方式、公司介绍、联系人。
这些段落占了全文的约五分之一,而且一年比一年多:
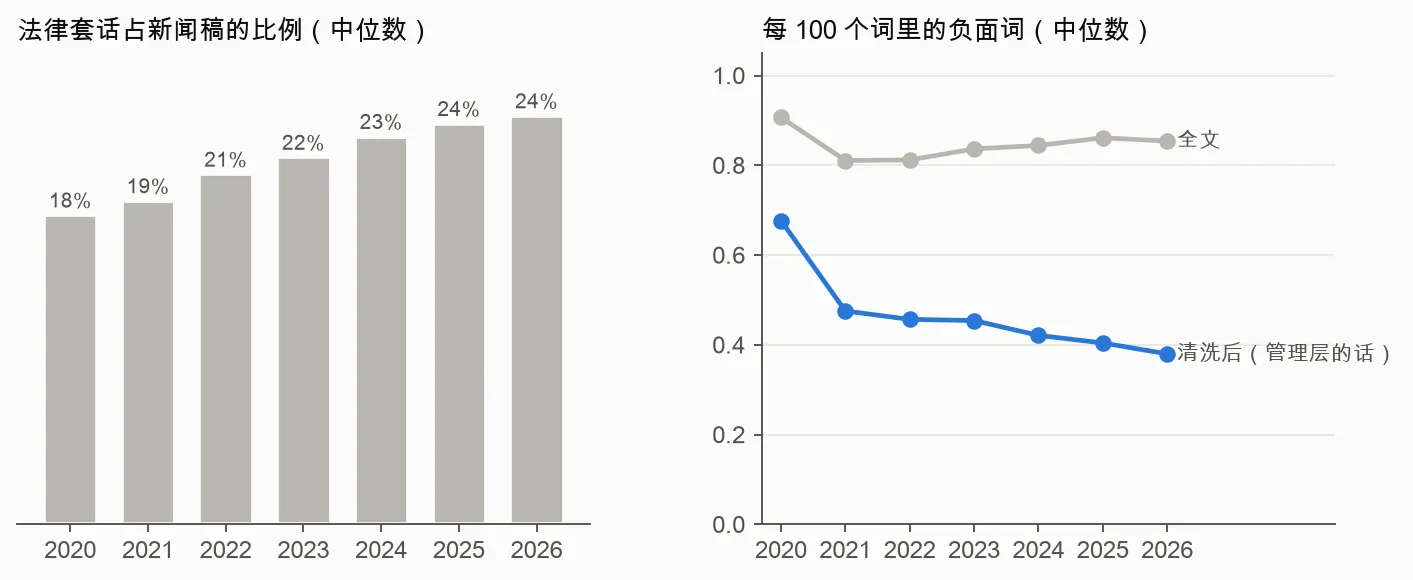
如果直接数全文的负面词,测到的是律师的措辞,而不是管理层的语气。左图里法律套话从 18% 涨到 24%;右图灰线是全文的负面词密度,被这些段落托在 0.85% 附近。清洗以后(蓝线),只剩管理层自己的话,负面词从 2020 年(疫情)的 0.67% 降到 2026 年的 0.37%:新闻稿一年比一年乐观。
清洗规则不是一次写对的,是看着失败的例子改了三次:
- 第一版最负面的几篇,是前瞻性声明后面没有标题的风险清单(Darden、Monarch Casino):“无法……”“失败……”“诉讼……”,只删掉了包含关键词的那一行,清单本身漏了进来。
- 第二版里,safe harbor 段落中被换行切短的句子,看起来像小标题,又把法律段“重新打开”了(Interface)。
- 第三版遇到了附件其实是幻灯片的公司(PSEG):法律页放在最前面,两栏文字被读成了一栏。
最后的规则:一句法律套话会关掉它所在的段落,直到下一个标题;全文前五分之一之后出现的前瞻性声明,一直关到结尾。中位数留下约 40% 的字。1.5% 的新闻稿剩下不到 100 个字,不打分,主要就是那些两栏混在一起的幻灯片。没有分数比错误的分数好。
第三课:词典是为 10-K 编的
打分用的是 Loughran-McDonald 金融情绪词典,它是金融文本研究的标准工具。它的好处是专门为财报编的:通用词典会把 liability(负债)、tax(税)、cost(成本)算成负面词,可它们在财报里只是会计科目,这个词典把它们剔掉了。
但它是为 10-K 年报编的,用在新闻稿上有两个问题:
- 不认识吹嘘的词:负面词有 2,345 个,正面词只有 347 个。新闻稿最爱用的 record(创纪录)、growth(增长)、exceeded(超过)都不在任何一类里,headwinds(逆风)也不算负面。有一家公司(OppFi)的标题是“创纪录的季度收入和净利润”,第一版却打了最低分 −1.00:record 不算正面词,全文一个正面词也没命中,只命中了几个负面词。
- 把科目名当成语气:LOSS 和 LOSSES 占了全部负面命中的 32%,GAIN 和 GAINS 占正面的 6%。它们大多是“net loss per share”“credit losses”这样的科目名,说的是公司亏没亏钱,不是管理层的口气。所以这几个词单独计数,不算进语气。
最后的分数是:每 100 个词里,正面词减负面词。原计划的“(正 − 负) / (正 + 负)”也放弃了:5% 的新闻稿一共只命中不超过 5 个词,只要没有正面词,不管多长都是 −1.00,太不稳定。
清洗和这两处修正之后,最负面的几篇读起来就是真正的坏消息了:Under Armour 的下滑和重组、Krispy Kreme 的网络安全事件(一篇里出现了 21 次 incident)、YETI 的产品召回(一篇里 recall 出现了 61 次)。
第四课:语气是公司的写作风格
最正面的五篇新闻稿,大部分来自同一家公司:T-Mobile,每个季度都是。
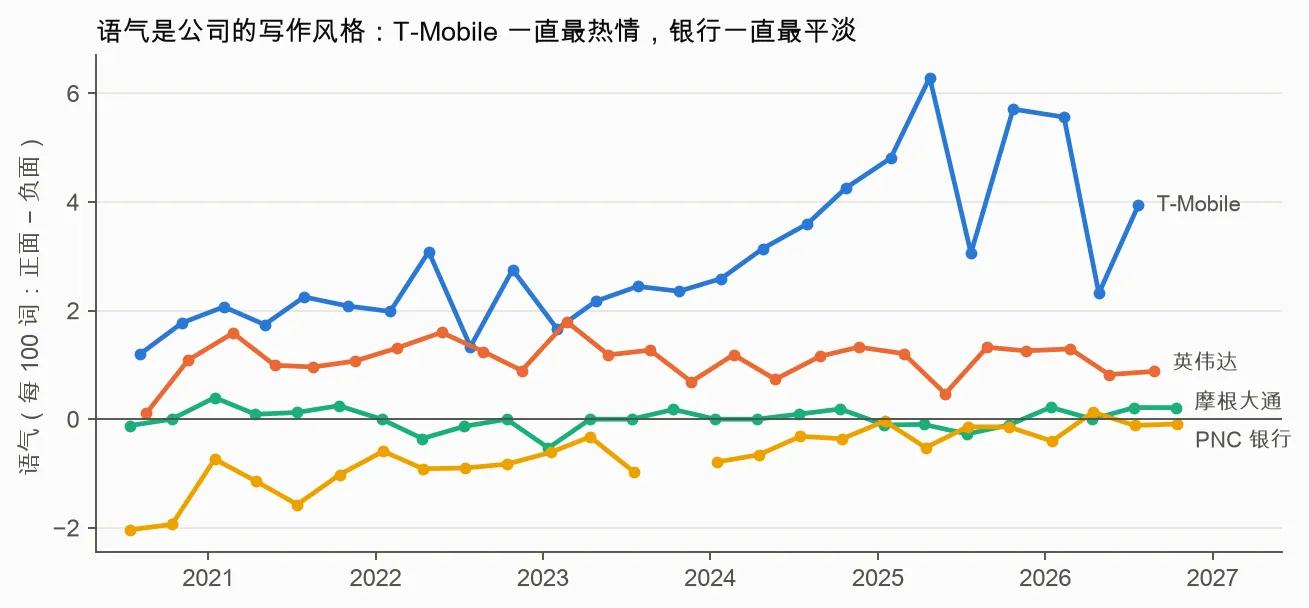
- 同一家公司这一期和上一期语气的秩相关是 +0.69,全部差异里约一半(51%)来自公司之间。
- T-Mobile 一直最热情,英伟达稳定地乐观,摩根大通和地区银行一直平平淡淡,几乎不用情绪词。
- 不算 LOSS 以后,亏损公司的新闻稿反而比盈利公司更乐观:生物科技和年轻的科技公司特别爱讲 progress(进展)和 opportunities(机会)。
所以“语气水平”测到的主要是这是一家什么样的公司,而不是这个季度发生了什么。信号要用变化:这一期减去同一家公司的上一期。T-Mobile 永远热情,它的语气比上一期又热情了多少,才是新闻。
第五课:我的预测错了,文字几乎和数字无关
动手之前我预测,语气变化和 SUE 的相关大概有 0.2–0.3:业绩超预期,管理层自然说得更开心。
实际只有 +0.06。用 SUE 和营收超预期去解释语气变化,平均只能解释 0.6%。管理层说话的口气,和数字超没超预期,几乎是两回事。这是一个好消息:如果语气有预测力,它会是一个真正独立的新信息。
第六课:市场当场就读完了
和之前一样,先做事件研究:把每份新闻稿按语气变化分成五组,比较最正面的一组和最负面的一组,看公告前后 60 个交易日的累计超额收益(股票减市场平均):
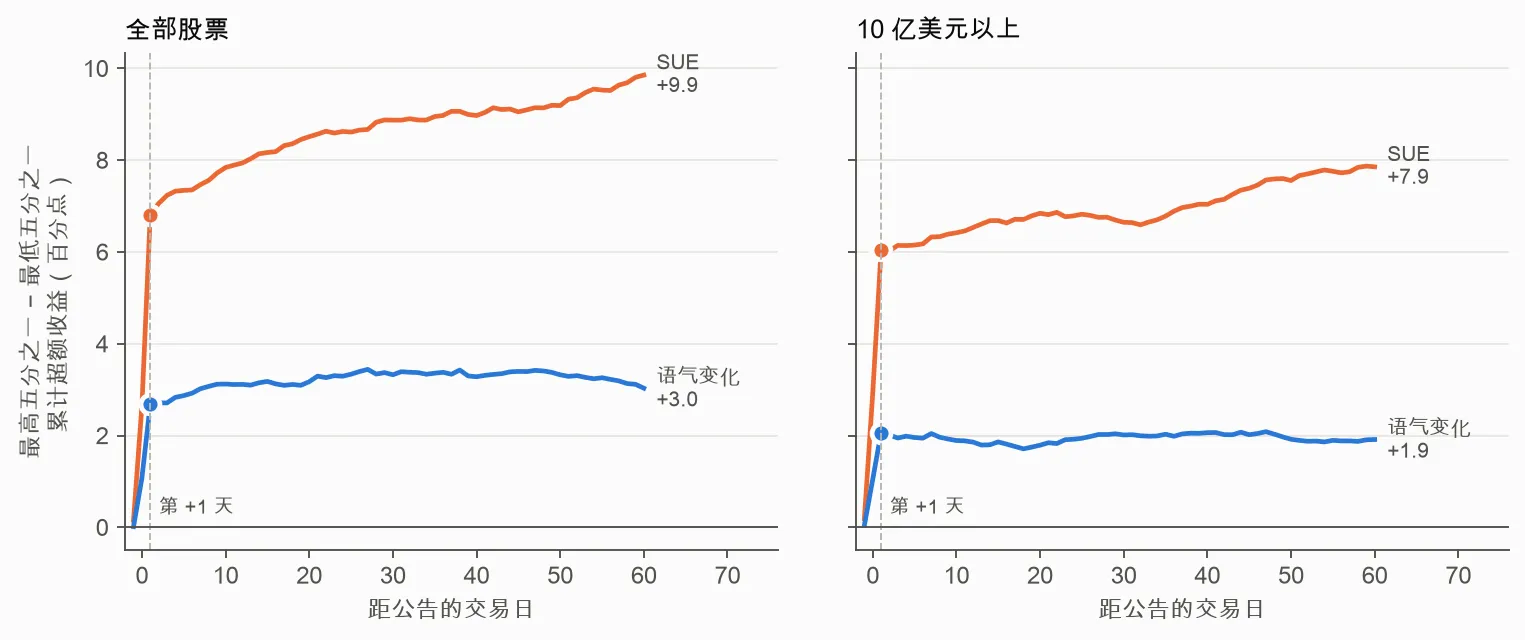
- 文字是新闻:第 −1 到 +1 天,语气变化最正面的一组比最负面的一组多涨 2.7 个百分点(t 值 16)。去掉 SUE 和营收能解释的部分,还有 2.1。市场确实在读这些字,不只是看数字。
- 然后就停了:蓝线在第 +1 天之后基本是平的。全部股票里之后 20 天再多 0.6,之后不再变化;10 亿美元以上的公司,前几周还略微回吐。
- 对比 SUE:橙线当天跳得更高(6.8),而且之后 60 天一直往上走,又多了约 3 个百分点。这就是第八篇的“盈余公告后漂移”。数字会漂移,文字不会。
第七课:成绩单
月度调仓,最早也要在公告后几天到几周才用上信号,只有漂移才吃得到。用第八篇同样的成绩单:
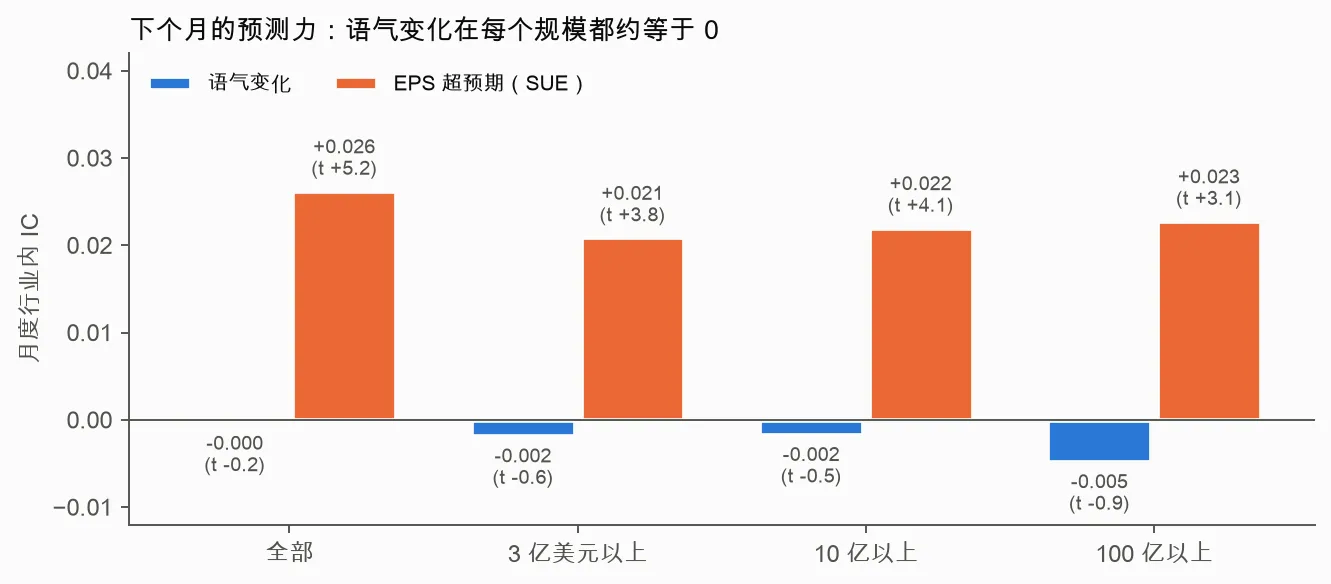
- 语气变化对下个月几乎没有预测力:行业内 IC 全部股票 −0.000,100 亿美元以上 −0.005,都不显著。去掉数字能解释的部分之后,6 年里没有一年是正的。按新闻稿发布多久分组,也没有一组有效。
- 赚不到钱:五分组多空每月约 −0.14%;只做多语气变化最正面的一组,扣成本后在每个规模都跑输股票池平均。
- 加进 SUE 反而有害:把 SUE 和语气变化的排名平均一下,IC 从 0.026 降到 0.019;在 100 亿美元以上的公司里,从 0.023 降到 0.011,只做多组合的超额收益从每月 +0.45% 降到 +0.13%。把一个没有前瞻信息的信号平均进来,只会稀释有信息的那个。
还有两个小尾巴,都不是大公司能用的策略:
- 语气水平是负的:IC −0.013(t 值 −3.1),越乐观的公司下个月表现越差。但它几乎全部来自亏损公司(−0.014),盈利公司里约为 0。这有点像“语气管理”:亏钱的公司讲着乐观的故事,之后股价更差。也可能只是生物科技公司天生乐观。它是公司的特质,不是新闻。
- 和去年同季度比的变化:IC +0.013(t 值 3.2),6 年都是正的,但到了 10 亿美元以上只剩 0.004。
为什么不再试 FinBERT 和大语言模型
原计划在词典之后,再用 FinBERT(专门训练过金融文本的模型)或者大语言模型来打分对照。我决定跳过:
- 词典已经能清楚地看到当天的反应(t 值 16),说明它抓到了真信息;问题不在打分不够准,而在信息被吸收得太快。
- 更好的打分,大概率只会让第 0、1 天的反应更清楚,变不出月度能用的漂移。
- 每多测一种方法,都会增加多重检验的次数,最后总能“找到”一个看起来显著的版本。这和上一篇跳过两个步骤是同一个理由。
和学界的对照
- 新闻稿语气有信息(Davis、Piger、Sedor 2012):在 2021–2026 年的数据里成立,公告当天的反应和语气变化同方向,而且不只是数字。
- 语气管理(Huang、Teoh、Zhang 2014):只在亏损公司的语气水平里看到一点影子。
- 10-K 词典用在别的文本上要小心(Loughran 和 McDonald 2011 的出发点就是通用词典在财报上不准):同样的道理反过来也成立,为年报编的词典用在新闻稿上,会漏掉“创纪录”,会把“净亏损”当成语气。
踩过的坑
- 只删关键词那一行不够:法律段是一整段,删掉“前瞻性声明”那一句,后面的风险清单还在。要按段落删。
- 数据格式不止一种:大部分新闻稿是 HTML,但有的公司把幻灯片当附件,还有 2 份是 PDF 被存成了文字。清洗规则要看过各种格式的失败例子才可靠。
- 一个索引对不齐的 bug:第一次算“这一期和上一期的相关”只有 +0.03,可同时又算出一半差异来自公司之间,两个数字互相矛盾。查下去是合并表格之后行的顺序变了,上一期对错了公司。两个结果互相矛盾时,先怀疑代码。
- 我的预测:语气和 SUE 的相关,我猜 0.2–0.3,实际 0.06。动手之前先写下预测,事后才知道自己哪里想错了。
结论和下一步
- 第三个新信号,第二次失败。新闻稿语气和分析师评级一样:是真新闻,但两天内就被价格吸收,月度调仓抓不到。
- 三个新信号放在一起看,答案很清楚:SUE、评级变动、新闻稿语气都是公告前后的新信息,只有 SUE 在大公司里有效,它也是唯一一个信息在两天以后还没有被吸收完的。选因子之前,先问它的信息多久会被价格吸收。
- 数据清洗决定了你测的是什么。不清洗,测到的是律师;不看极端例子,测到的是风险清单;不用变化,测到的是公司的写作风格。
下一步是 P13:把前面所有的结果写成一份完整的研究报告,事先固定一个策略(目前唯一站得住的是大公司里按 SUE 选股的只做多组合),然后开始模拟盘:每月月底按规则生成组合,用之后的真实收益来检验。