量化选股学习笔记(二):因子是真的,还是只是行业?
把 40 个因子放到每个行业内部重新检验:“避开亏损公司”在 11 个行业里全部成立,杠杆的反向基本是银行造成的,价值因子在行业内部反而是反的。另外修正了上一篇的一个结论。
这是我学习量化选股的第二篇笔记。上一篇用 5 年美股年报数据测了 40 个单因子,结论是:几乎所有有效的信号都在讲同一件事,避开亏损公司。代码仍然由 Claude Code 编写,我负责提问、读代码和决定方向。
本文是学习记录,不构成任何投资建议。
上一篇留下的问题
上一篇所有的 IC 都是在全市场里算的。但盈利类因子最差的 20% 里,医疗健康公司的占比大约是正常水平的 3 倍,主要是亏损的生物科技公司。于是有三个问题没有回答:
- “避开亏损公司”是真的会选股,还是只是在“避开生物科技”?
- 学界很看重的毛利/总资产(Novy-Marx, 2013)在我们的数据里很弱,是不是因为行业?
- 杠杆的方向和理论相反(高杠杆的公司反而表现更好),是不是因为银行?
回答这些问题的工具叫行业中性化。
什么是行业中性化
一句话:只把每只股票和同一年、同一行业的股票比较。
可以想成一场考试。如果几个班用的卷子难度不同,跨班比较分数,比出来的主要是哪张卷子更容易,在班级内部排名才公平。股票也一样,每个行业就是一个“班”,而不同行业之间的收益和财务比率差别很大。
一个因子在全市场里“有效”,收益可能来自两个地方:
| 来源 | 含义 |
|---|---|
| 行业押注 | 因子恰好偏向某些行业,而这些行业当年表现更好 |
| 行业内选股 | 在同一个行业里,高分公司跑赢低分公司 |
用一个 6 只股票的例子说明行业押注怎样造出假信号:
| 公司 | 行业 | 是否盈利 | 下一年收益 |
|---|---|---|---|
| A | 科技 | 是 | +10% |
| B | 科技 | 是 | +12% |
| C | 科技 | 否 | +11% |
| D | 医疗 | 是 | −12% |
| E | 医疗 | 否 | −10% |
| F | 医疗 | 否 | −11% |
在全市场看,盈利组平均 +3.3%,亏损组平均 −3.3%,“是否盈利”好像赢了 6.6 个点。但在行业内部看,科技股里盈利和亏损的公司都是 11%,医疗股里盈利的公司反而更差。这个信号完全来自“科技行业盈利公司多,而医疗行业那年下跌”,因子本身根本不会选股。
行业中性化就是把第一种来源去掉,只留下第二种。
第一课:行业的影响比单个因子大得多
先看每个行业的中位数收益,减去当年所有股票的中位数:
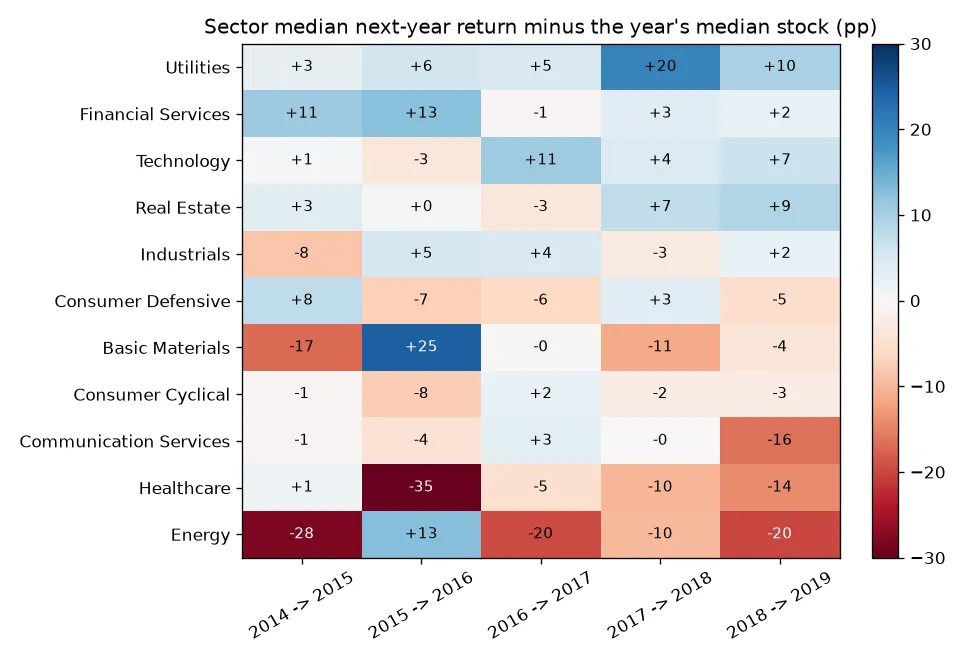
- 医疗在 2015 → 2016 年比市场中位数低了 35 个点。
- 能源 5 年里有 4 年落后市场 10 到 28 个点。
- 公用事业 5 年都跑赢市场。
光是“属于哪个行业”,每年就能解释股票之间收益排名差异的 3%–14%。听起来不多,但如果事先知道每个行业当年的表现(也就是完美的行业择时),Rank IC 能达到 0.14–0.36,5 年里有 4 年超过上一篇最好的单因子(0.169)。
换句话说,一个因子只要恰好偏向对的行业,不用选对任何一只股票也能看起来很好。 更麻烦的是,表现最差的两个行业,能源和医疗,恰好也是亏损公司最多的两个行业(45% 和 73%,全市场是 34%)。这种重叠正是要拆开的东西。
第二课:怎么做,同一个数字换个参照系
做法很简单:在每个行业、每一年内部,把因子值换成 0 到 1 之间的百分位排名。收益也同样在行业内部排名。代码上只是把分组从 groupby(year) 改成 groupby([year, sector])。
以 2018 年的杠杆(总资产 ÷ 股东权益)为例,排名越接近 1 表示杠杆越低:
| 公司 | 杠杆 | 全市场排名 | 行业内排名 |
|---|---|---|---|
| 摩根大通(银行) | 10.2 | 0.07 | 0.22 |
| 美国银行(银行) | 8.9 | 0.10 | 0.38 |
| 苹果(科技) | 3.4 | 0.31 | 0.15 |
- 借钱本来就是银行的生意,所以整个金融行业在全市场排名里都挤在“最差”的那一端(平均 0.23)。在银行内部比,美国银行只是一家普通的银行。
- 苹果正好反过来:3.4 的杠杆在全市场算中等,在科技公司里却偏高。
- 同一个数字,换一个参照系,结论就不一样。
收益也一样。杜克能源 2019 年涨了 12.4%,但公用事业的中位数涨了 27.4%,所以在行业内部它只排 0.27,股价涨了,却跑输了同行。
每个因子我算了三个 IC:
| 怎么算 | 回答什么问题 | |
|---|---|---|
| 原始 IC | 上一篇的算法,全市场排名 | 原来的结果 |
| 只看行业 | 每只股票只用它所在行业的平均得分 | 光靠行业偏好能得到多少 IC |
| 行业中性 IC | 因子和收益都在行业内部排名 | 纯粹的选股能力 |
第三课:40 个因子,中性化前后对比
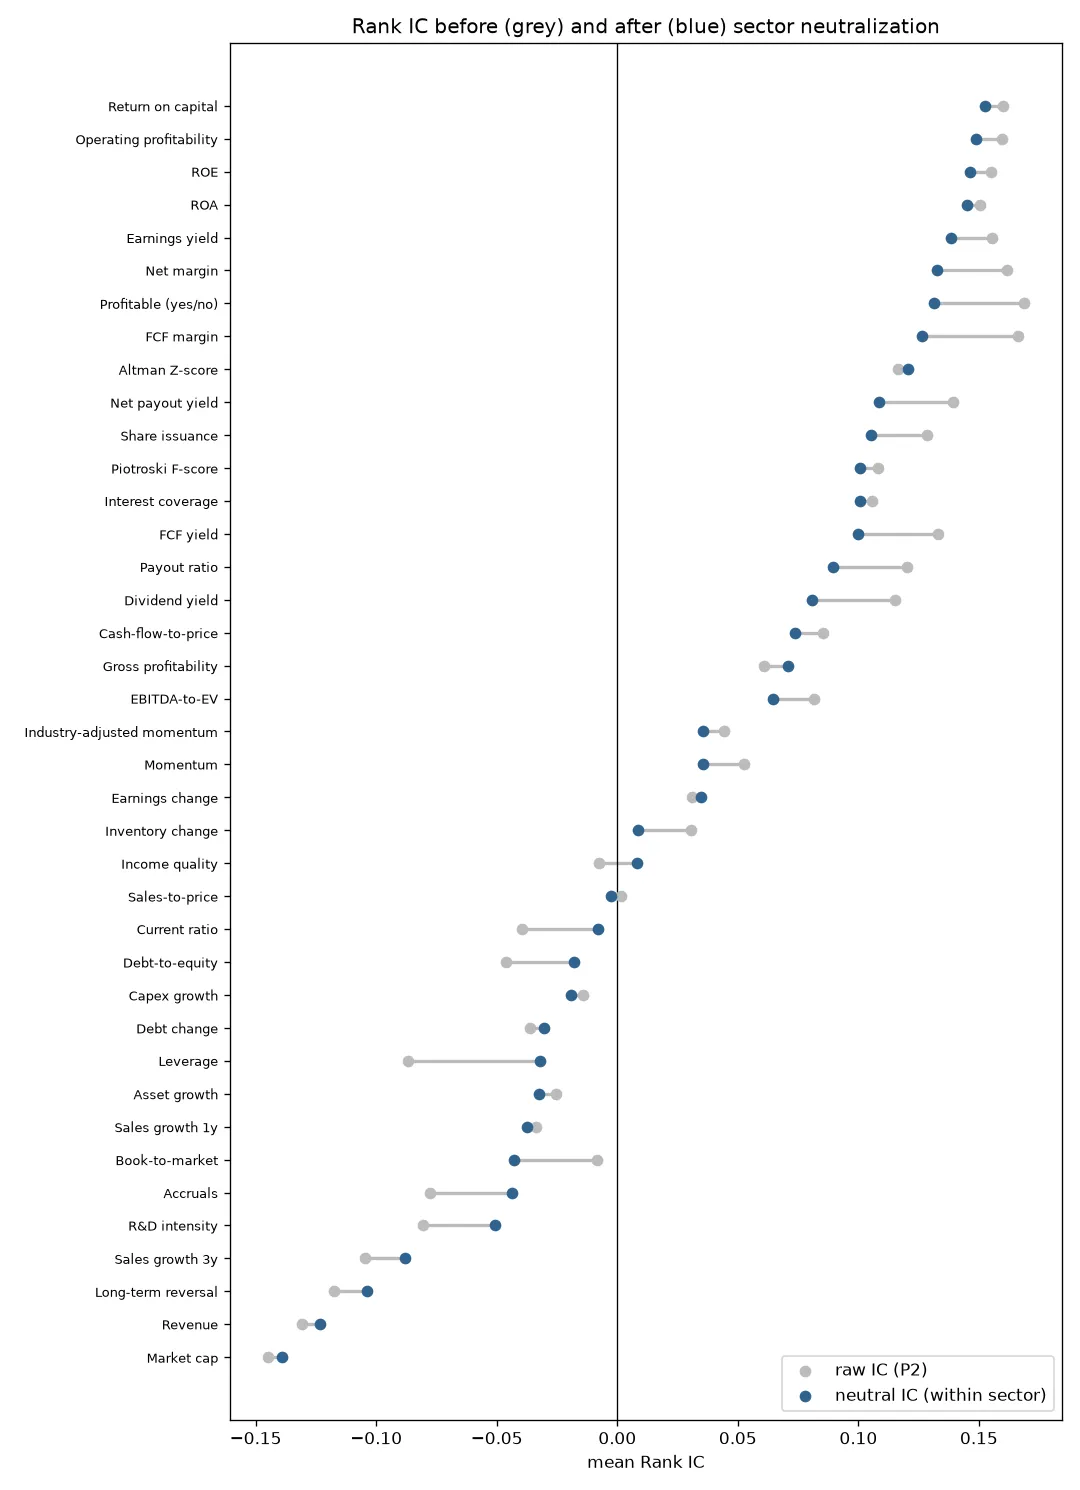
总体来看,40 个因子里有 30 个变弱,平均 |IC| 从 0.091 降到 0.078。大部分信号是真实的选股能力,但不是全部。
| 因子 | 原始 IC | 只看行业 | 行业中性 IC | 保留 |
|---|---|---|---|---|
| 是否盈利 | +0.169 | +0.103 | +0.131 | 78% |
| 自由现金流率 | +0.166 | +0.124 | +0.126 | 76% |
| ROA | +0.150 | +0.001 | +0.145 | 97% |
| Altman Z-score | +0.116 | +0.082 | +0.121 | 104% |
| 毛利/总资产 | +0.061 | −0.038 | +0.071 | 116% |
| 杠杆(理论方向) | −0.087 | −0.101 | −0.032 | 37% |
| 账面市值比 | −0.008 | +0.070 | −0.043 | — |
| 市值(理论方向) | −0.145 | +0.008 | −0.139 | 96% |
| 库存变化 | +0.031 | +0.082 | +0.009 | 28% |
三个问题的答案:
- “避开亏损公司”基本是真的。 “是否盈利”保留了 78%,5 年全对。大约 1/4 来自行业押注:亏损公司多的行业恰好也是这几年最差的行业,这个押注这次赚了钱,但不保证下次还能赚。ROA 只看行业时的 IC 只有 +0.001,说明它的 0.150 几乎全是选股能力。
- 毛利/总资产略有改善,从 +0.061 升到 +0.071。它的行业偏好反而拖了后腿:它把银行、REITs、公用事业排在最后,而这几个行业表现不错。
- 杠杆的反向基本是行业造成的,只保留了 37%。
第四课:“避开亏损公司”在每个行业都成立
再往下拆一层,在每个行业内部单独算 IC:
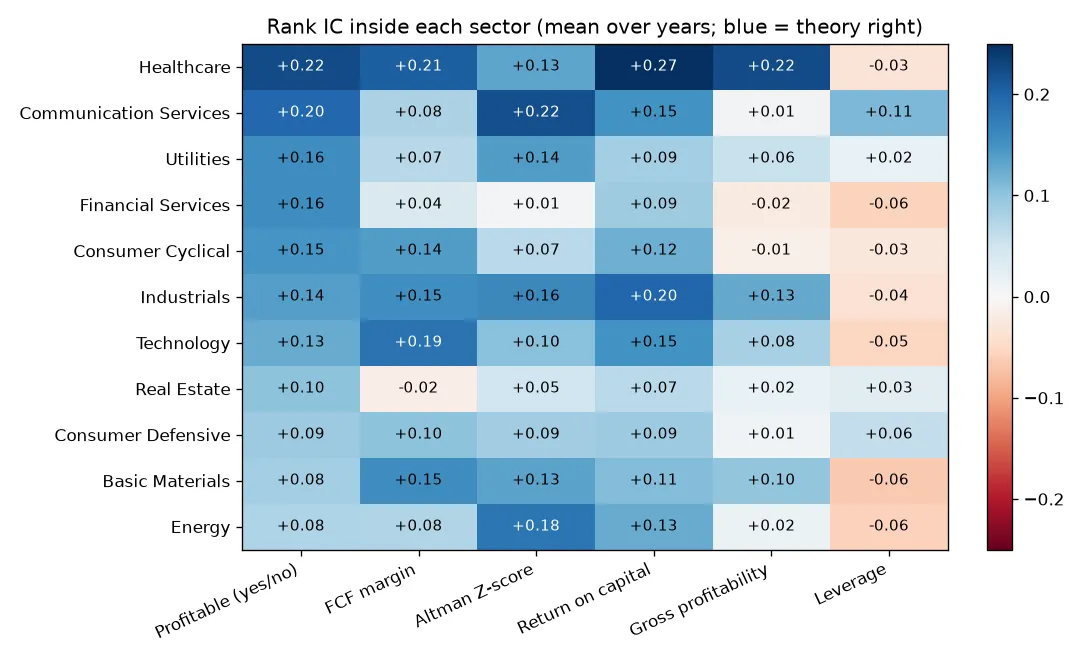
“是否盈利”在 11 个行业里全部为正,每个行业都是 4 到 5 年方向正确。在行业内部,盈利公司比亏损公司多赚的中位数收益:
| 行业 | 亏损公司占比 | 盈利 − 亏损(百分点) |
|---|---|---|
| 医疗 | 73% | +28.0 |
| 金融 | 9% | +15.2 |
| 可选消费 | 21% | +14.9 |
| 科技 | 43% | +11.8 |
| 原材料 | 37% | +5.2 |
| 能源 | 45% | +4.3 |
- 医疗反而最强。 亏损的生物科技公司不只是跑输整个市场,连医疗行业里的同行都跑不过。把医疗整个删掉,中性 IC 仍然有 +0.106,5 年全对。所以“避开亏损公司”不只是“避开生物科技”。
- 能源和原材料最弱。 大宗商品公司亏损,往往是因为商品价格下跌,不是公司本身的问题,价格一反弹就反转。2015 → 2016 年,这两个行业的亏损公司分别跑赢盈利公司 12 和 29 个点,这和上一篇提到的“动量崩溃”是同一件事。
另外两个发现:
- 因子要和商业模式匹配。 自由现金流率在医疗(+0.21)和科技(+0.19)里很强,在金融(+0.04)和房地产(−0.02)里几乎没用:银行谈不上“自由现金流”,REITs 的“资本开支”其实是在买楼。Altman Z 本来就是为制造业设计的,在银行里也接近 0。
- 最通用的是投入资本回报率:11 个行业全部为正。
读这张表要注意噪音。一个完全没用的因子,在 n 家公司上算出的 IC 也会随机偏离 0,幅度大约是 1/√n,5 年平均后大约是 1/√(5n)。医疗每年约 640 家公司,噪音只有 0.018;通信服务每年只有 75 家,噪音是 0.052。小行业里 0.1 左右的 IC,可能只是运气。
第五课:毛利/总资产和杠杆,问题都出在银行
毛利/总资产。 Novy-Marx 的论文本来就把金融公司排除在外,按他的做法再算一次:
| 样本 | IC |
|---|---|
| 全部行业 | +0.061 |
| 去掉金融 | +0.114 |
| 去掉金融、房地产、公用事业 | +0.143 |
| 只看盈利公司,且去掉金融 | 约 +0.03 |
对一家资产主要是贷款的银行来说,“毛利 ÷ 总资产”这个数字本身就没有意义。去掉金融后 IC 几乎翻倍。但它主要在医疗里起作用(+0.22),因为没有产品的生物科技公司没有毛利。只看盈利公司时只剩 +0.03 左右,在“是否盈利”之外,它补充的信息不多。
杠杆。 去掉银行之后,还剩一点反向(−0.027)。把每个行业内部按杠杆分成五组,看问题出在哪里:
| 行业内按杠杆分五组 | 亏损公司占比 | 相对行业中位数 |
|---|---|---|
| 杠杆最高的 20% | 34% | +0.7 |
| 中间 20% | 27% | +1.2 |
| 杠杆最低的 20% | 39% | −3.3 |
问题不在杠杆最高的一组,它们并没有因为“财务困境”受罚。问题在杠杆最低的一组:几乎不借钱的公司,很多是借不到钱的公司,也就是靠向股东融资维持的亏损公司。医疗行业里杠杆最低的 1/5 有 85% 在亏损,原材料(小型矿企)54%,能源 51%。
这和上一篇里规模、营收增长的问题一样:理论上“应该更好”的那一组,挤满了亏损公司。
第六课:被行业掩盖的东西
中性化不只是让因子变弱,也会让隐藏的东西露出来。
- 价值因子在行业内部是反的。 账面市值比只看行业时的 IC 是 +0.070,因为“便宜”的行业(金融、能源、REITs)跑赢了“贵”的医疗。但在行业内部,IC 是 −0.043,5 年只对了 1 年:同一个行业里,越便宜的股票表现越差。 上一篇里它看起来“接近 0”,其实是一个真实的失败,被一次幸运的行业倾斜掩盖了。这几年正是价值投资“失去的十年”。
- 规模效应和行业无关。 市值从 −0.145 到 −0.139,几乎没变。小型亏损公司在每个行业里都有。
- 有些因子几乎全是行业效应。 库存变化只看行业时 +0.082,中性化后只剩 +0.009;资本开支增长从 +0.067 变成 −0.019。
第七课:修正上一篇的一个结论
上一篇的第二个主要结论是:“在赚钱公司内部仍然有效的,是现金流和财务稳健”。在行业内部再检验一次,这个结论要打折扣:
| 因子(只看赚钱公司) | 上一篇(全市场) | 行业中性后 |
|---|---|---|
| 自由现金流率 | +0.089 | +0.057 |
| 净利率 | +0.051 | +0.022 |
| Altman Z-score | +0.080 | +0.074 |
| 利息保障倍数 | +0.051 | +0.048 |
| 投入资本回报率 | +0.040 | +0.056 |
| 经营利润率 | +0.028 | +0.050 |
自由现金流率和净利率的“额外信息”有一部分也是行业带来的。最稳的是 Altman Z-score,几乎不受行业影响,在全部公司里它中性化后甚至保留了 104%。投入资本回报率和经营利润率在行业内部反而变强了。
第八课:在行业内部,最好的那一组也开始赚钱
上一篇发现收益很不对称:有效因子的信号几乎全部来自最差的 20%。在行业内部重新分组:
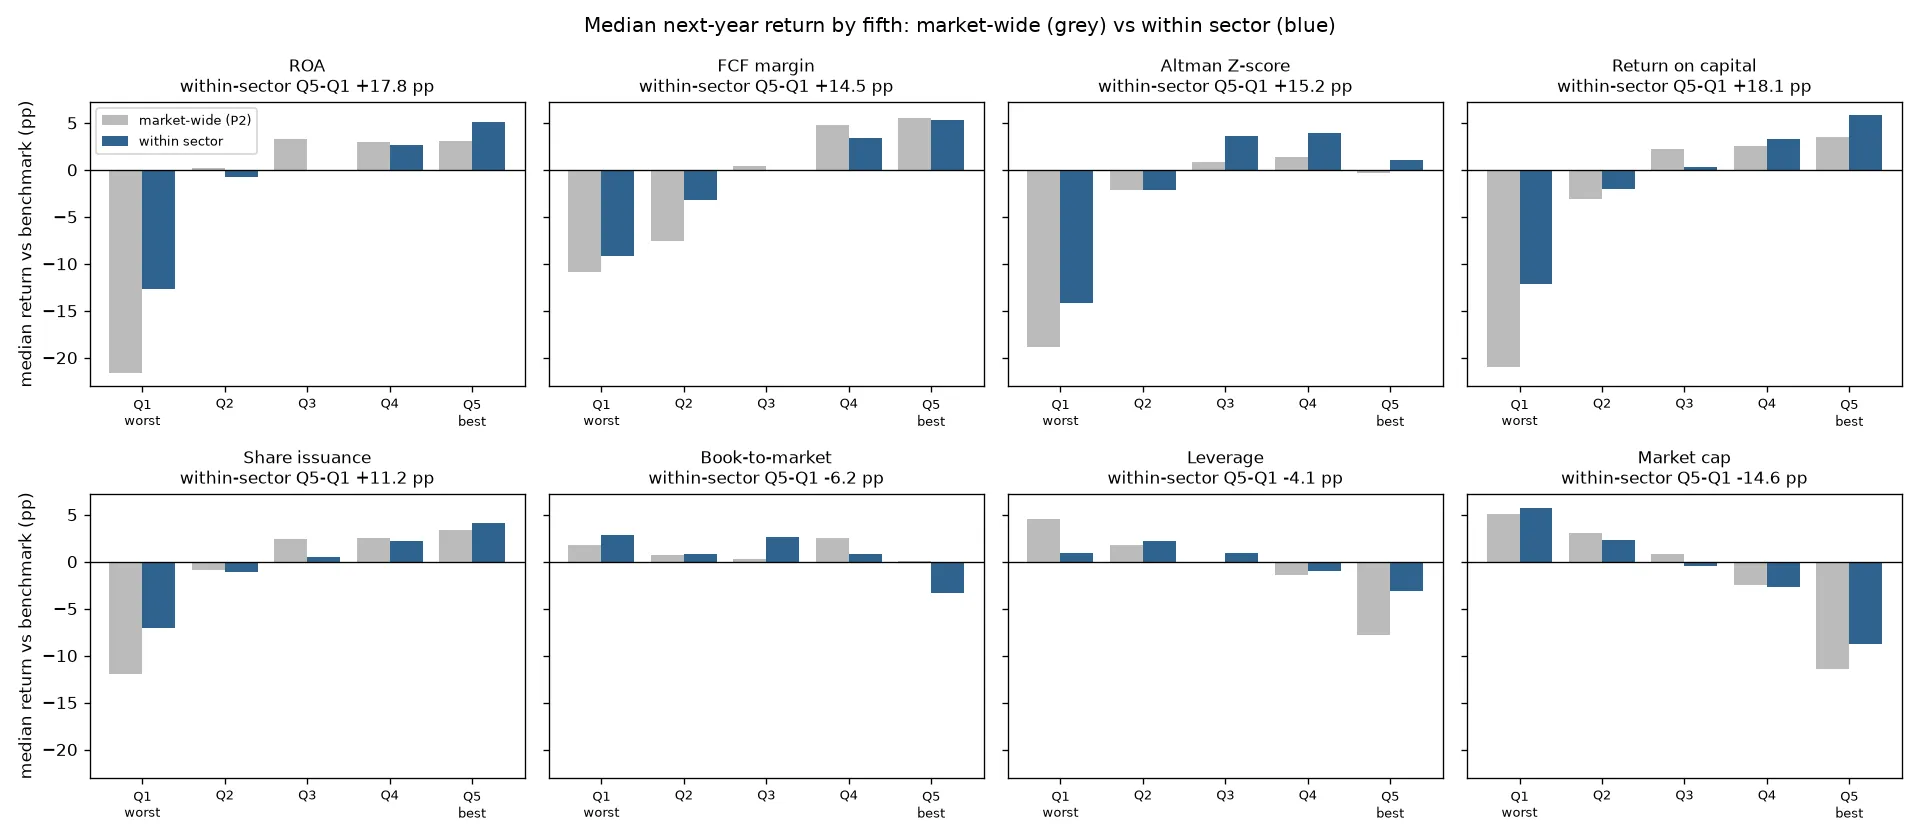
- 不对称仍然存在。 差距超过 10 个点的 13 个因子,全部是最差一组贡献得更多。“避开自己行业里最差的 1/5”依然是最重要的一条。
- 但最好的一组也开始有用了。 ROA 最好一组相对中间组的差距,从上一篇的 −0.2 变成 +5.1 个点;投入资本回报率 +5.6,自由现金流率 +5.4,几乎是一条干净的台阶。在全市场看,“利润超过中等水平后再高也没用”;和同行比,利润最高的公司确实更好。
- Altman Z 的形状没变:最脆弱的一组很惨(−14.1),最安全的一组反而略低于中间组。避开最脆弱的就够了,极度安全并不额外加分。
第九课:去极值和标准化,Rank IC 不需要,合成因子需要
量化教材里,因子预处理通常是三步:去极值、标准化、中性化。这一轮我才搞清楚前两步什么时候重要。
财务数据的尾巴非常极端。自由现金流率的中位数是 0.05,最小值是 −23,256(一家收入极小的公司,负的自由现金流是收入的 2 万多倍),离均值 64 个标准差。
对 Rank IC 来说,这完全不影响。 不做处理、z-score、去极值后再 z-score、转成排名,四种方式算出的 IC 精确到小数点后四位都一样(+0.1660)。只要变换不改变股票的先后顺序,排名就不变,IC 也就不变。所以前面的分析一直不需要这两步。
但把两个因子加起来合成时,用到的是数值的大小,不只是顺序。 用自由现金流率和 Altman Z 等权合成:
| 合成方式 | 合成后 IC | 和自由现金流率的相关 | 和 Altman Z 的相关 |
|---|---|---|---|
| 原始 z-score | +0.143 | 0.36 | 0.73 |
| 1%/99% 去极值 + z-score | +0.142 | 0.40 | 0.91 |
| 排名 | +0.183 | 0.79 | 0.78 |
(在同一批公司上,单用自由现金流率的 IC 是 +0.182。)
- 用原始 z-score 时,合成后的 IC 还不如单用自由现金流率。那个 −23,256 把自由现金流率的标准差撑得很大,结果 98% 的公司在它上面的 z-score 几乎没有差别,排序基本由 Altman Z 决定,它“劫持”了合成结果。
- 常见的 1% 去极值对这么肥的尾巴不够用,Altman Z 的主导反而更强。
- 用排名合成,两个因子才是均衡的。但即使均衡,在全市场里也只是和单用自由现金流率打平;在行业内部合成(+0.174),才同时超过了两个单因子(+0.158、+0.122)。合成不是自动就更好,这是下一步要研究的问题。
和学界的对照
- Fama 和 French (1992) 就把金融公司排除在样本外,理由是高杠杆对银行是正常的,对其他公司却可能意味着困境。我们的杠杆结果正好说明了为什么。
- Novy-Marx (2013) 的毛利/总资产也排除了金融公司。按他的做法,这个因子明显变强,但在我们这几年的数据里,它在“是否盈利”之外补充的信息不多。
- 行业调整动量就是行业内动量。 Moskowitz 和 Grinblatt (1999) 认为个股动量很大一部分来自行业动量。在行业内部排名时,“动量”和“行业调整动量”的结果完全一样,因为减去行业中位数不改变行业内部的顺序。
- 业界的风险模型(例如 Barra 一类)通常会把行业和市值同时中性化,很多基金也要求行业权重和基准一致,超额收益只能来自选股。只靠行业押注才有效的因子,在这类基金里没法用。
踩过的坑
- 全部并列的组会造出假信号。 行业动量在同一行业里每只股票的值都一样,行业内部排名时全部并列。并列的百分位约等于 0.5 + 1/(2n),会随行业大小变化,结果算出了 t 值 +53.5 的假信号。现在全部并列的组直接算作没有排名。
- 没用的列。 我一开始在“行业内按杠杆分五组”的表里加了一列“医疗占比”,结果每组都是 15%,因为分组本来就是在每个行业内部做的,这一列从构造上就不可能有差别。
- 小行业的数字要先看噪音,见第四课。
- 聚类的边界很脆弱。 市值和 ROA 的相关性几乎没变(−0.45 → −0.43),却从“盈利”那一类里分了出去。聚类只能看成“大致属于哪个故事”。
- 比较要用同一把尺子。 行业内部合成的 IC 一开始被我拿去和全市场的单因子 IC 比较,后来改成在同一批公司上、用同一种 IC 比较。另外 Altman Z 在 91% 的银行和 87% 的 REITs 上缺失,所以合成实验的样本其实基本是非金融公司。
局限和下一步
- 行业分类很粗。 只有 11 个大行业,生物科技和大型药企都算“医疗”,中性化之后“避开生物科技”的影响可能仍然部分存在。更细的行业分类要等换成 FMP 的数据。
- 仍然只有 5 年的年度数据,上一篇提到的幸存者偏差和时间对齐问题也都还在。
带进下一步的核心因子,每个故事选一个,方向都和理论一致:盈利(盈利收益率 / 投入资本回报率)、现金流(自由现金流率)、安全(Altman Z)、融资(股票发行)、分红(股息率)。
下一步是多因子合成:从等权平均开始,到用过去的 IC 加权、线性回归,再到树模型,全部用 walk-forward 只拿过去的年份训练,看合成之后能不能稳定地超过最好的单因子,以及机器学习在只有 5 年年度数据时到底能帮多少。