股票评级研究笔记(一):先建一个数据库,再做研究
想每天给几千只美股打 S/A/B/C/D 评级,第一个卡点不是模型,是数据:在 QuantConnect 的研究环境里每个 notebook 自己拉 20 年数据,内存先爆了。后来照自己以前的做法,用回测把 Morningstar 基本面和日线一次性整理进 Object Store,所有研究读同一份。记录一路踩到的内存坑和检查出的数据问题。
这是一个新系列的第一篇。目标很具体:每天开盘前,给一批美股打 S/A/B/C/D 五档评级,S 是“未来 12 个月最可能跑赢 SPY 的那 10%”。评级怎么定义、怎么判断一个模型好不好,是下一篇的内容;这一篇讲做研究之前的那一步:把数据整理成一个能反复用的数据库。代码仍然由 Claude Code 编写,我负责提问、读代码和决定方向。
之前的量化选股学习笔记用的是我自己的框架和 FMP 的数据。这次换到 QuantConnect(下面简称 QC),原因有两个:一是 QC 有 Morningstar 的基本面数据,能回到 2006 年,而且包括后来退市的公司(FMP 里 2020 年以前退市的公司几乎没有,回测会有幸存者偏差);二是 QC 能直接在云上每天定时跑,结果推送出去,不用我自己维护服务器。
本文是学习记录,不构成任何投资建议。
第一次:每个 notebook 自己拉数据
最开始的做法很直接:在 QC 的研究环境(云上的 Jupyter)里开一个 notebook,用 universe_history 按月拉出每家公司当时的市值和基本面,再拉价格,然后算评级、看结果。
前 500 家公司、18 年,能跑,几分钟。股票池扩大到 3,000 家,就跑不动了:
- 研究容器只有 5 GB 内存。
universe_history第一次调用就占约 3.3 GB,之后每拉一个月再多约 15 MB,而且回收不掉。20 年 240 个月,拉到一半就到顶。 - 我加了内存检查,快到上限就主动停下,结果就是 notebook 跑到一半停住,重启内核、从缓存续上、再停。
- 更麻烦的是,每个研究都要把这一大段“拉数据、检查数据”重写一遍。真正想研究的东西只占 notebook 的一小部分。
当时我的反应是:每次做研究,都要写这么一大堆前置的数据获取和检验吗?以前在自己的框架里不是这样的:数据整理成一组 parquet 文件,研究只管读。
思路:数据只建一次
于是照以前的做法来:数据只建一次,所有研究读同一份。
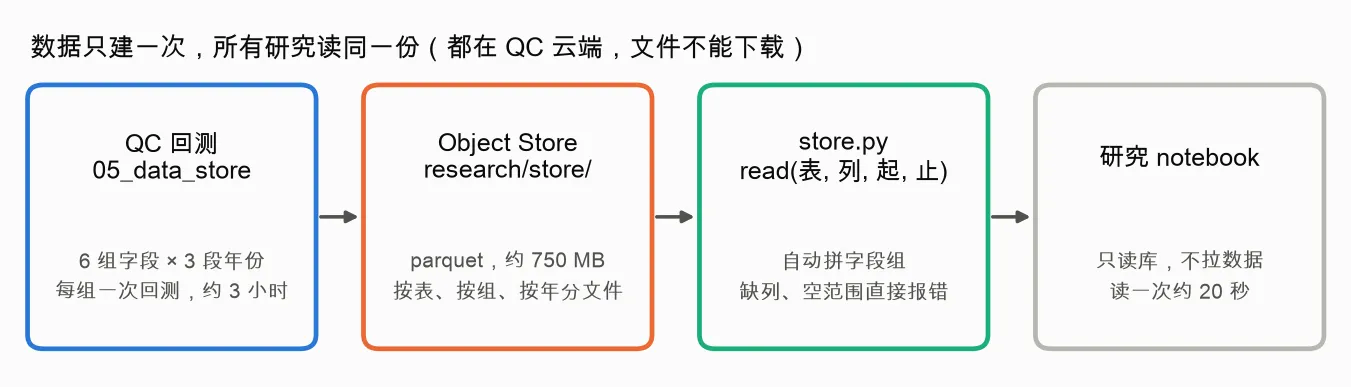
放在哪里?QC 有一个组织共用的 Object Store(键值存储,存文件用),研究环境和回测都能读写。默认只有 50 MB,升级到 2 GB 是每月 12 美元,我升级了。
这里有一个 QC 的限制要先说清楚:Object Store 里的文件不能下载到本地。QC 的数据授权不允许把原始数据带出云端,所以整个研究都只能在 QC 上跑,带出来的只有统计结果和图。本系列里所有的数字也都是这样来的:比例、中位数、t 值,没有任何一家公司的具体数值。
用回测来建库,而不是 notebook
建库用的是 QC 的回测,不是研究 notebook。回测按日期一天天往前走,每个月第一次选股时,选股函数看到的就是那一天 Morningstar 已有的数据,天然没有“用到未来”的问题;回测也没有 universe_history 那个越拉越多的内存问题。另一个好处是 Claude 能用 QC 的命令行工具自己启动回测、读日志核对,不用我在网页上点。
每个月存一张横截面:当天所有普通股(每家公司只留成交额最大的那只,不含 ADR),119 个 Morningstar 字段,加上价格、市值、行业。再加四张价格表:交易日历、SPY 等几只 ETF 的日线、每只股票的月度价格、每只股票的日线。
内存坑:一次读完所有字段,第一个月就被杀
回测节点是 8 GB。第一版一次读全部约 120 个字段,第一个月就被杀了,日志里什么都没有,只有一行 Killed。
加了一个只打印内存的探测参数,量下来:LEAN 读 Morningstar 字段时,每个字段、每家公司大约占 24 KB,直到当天的选股结束才释放。120 个字段 × 4,500 家公司,就超过 8 GB 了。换成每次新建对象、手动垃圾回收都没用。
解决办法是拆:
- 按字段分组:估值、比率、利润表、现金流量表、资产负债表五组,每组 20–27 个字段,加一组标识字段(代码、价格、市值、行业、日期)。每组单独跑一次回测,选股那天的内存峰值降到约 4 GB。
- 按年份分段:一组字段一口气跑 20 年,内存还是会一路涨(估值组 2006 年 2.7 GB,到 2025 年 7.3 GB)。所以每组再分三段跑:2006–2012、2013–2019、2020–2026,每段从头开始。
- 每存一个文件就更新目录(manifest):中途被杀,也不丢已经写好的年份。
6 组 × 3 段,加上价格表,一共约 3 小时,最高一段用到 7.2 GB。建好的库约 750 MB:月度横截面 323 MB,日线 402 MB,月度价格 27.5 MB。
还有两个小坑:Object Store 的文件名里只能有一个点(monthly/base/2024.parquet 可以,monthly/2024.base.parquet 会报“路径不支持”);回测最后一刻存的文件,要一两分钟后才查得到,别以为没存上就马上重跑。
库的样子
| 表 | 文件 | 内容 |
|---|---|---|
| monthly | monthly/<组>/<年>.parquet |
每月一张横截面,每家公司一行,6 组共 119 个字段 |
| calendar | calendar.parquet |
交易日 |
| etf_daily | etf_daily.parquet |
SPY、RSP(等权 S&P 500)、IWM、QQQ 的复权日线,只作基准 |
| prices_monthly | prices_monthly.parquet |
每只股票每月第一个、最后一个交易日的复权收盘价等 |
| prices_daily | prices_daily/<年>.parquet |
每只股票的复权日线 |
读库只有一个函数。字段分在哪一组、在哪几个文件里,由它根据目录自己拼起来;要的列不存在、范围是空的,直接报错,不会悄悄返回空表:
from store import read

u = read(qb, "monthly", columns=["sid", "month", "mcap", "net_income", "roic"], first="2008-01")
px = read(qb, "prices_daily", columns=["sid", "date", "close", "volume"], first="2024-01", last="2024-12")
研究 notebook 从此只读库,开头那一大段拉数据的代码没有了,读一次 3,000 家公司 18 年的数据约 20 秒。
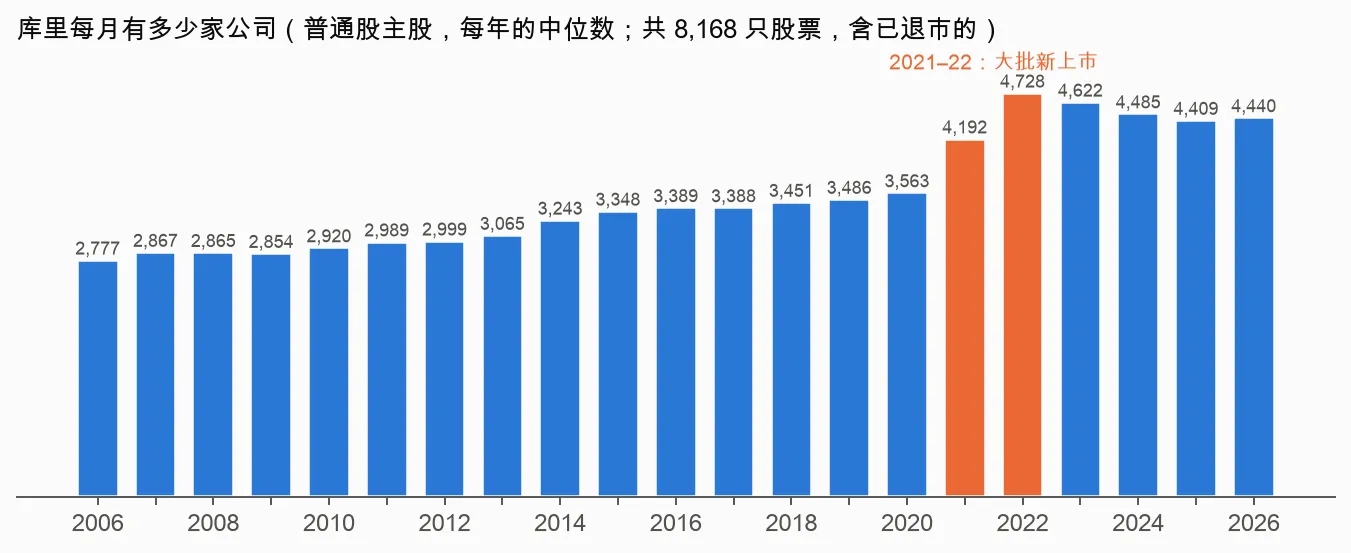
库里一共 8,168 只股票,每月 2,800 到 4,700 家。2021、2022 年多出来一千多家,多半是那两年的上市潮;同样是这几年,新公司的行业代码缺得最多(见下面的覆盖率图)。
检查:库里的数据对不对
建好以后,单独写了一个检查 notebook,以后每次重建都跑一遍,几秒钟。检查项是跑之前就定好的:每张表在不在;每家公司每月是不是只有一行;价格覆盖了多少(99.96%);几个已知的公开数字对不对(某大公司的市值和市盈率在公开范围内、SPY 2024 年全年收益在 +20% 到 +30% 之间);日线和月度价格算出的同一段收益是否一致。
大部分通过了。没通过、或者通过了但值得记下来的有这几件:
1. 快照有三分之一的月份晚了一天。 247 个月里,73 个月的“当月第一次选股”发生在第二个交易日的 0 点,用的是第一个交易日收盘后的数据。研究的收益从第一个交易日的收盘算起,所以不算用到未来,但比实盘(开盘前评级)晚了一个收盘。这件事要写进每个研究的约定里:收益从当月第一个交易日的收盘开始算,不能从开盘算。
2. 有些字段早年是空的,有些一直不全。
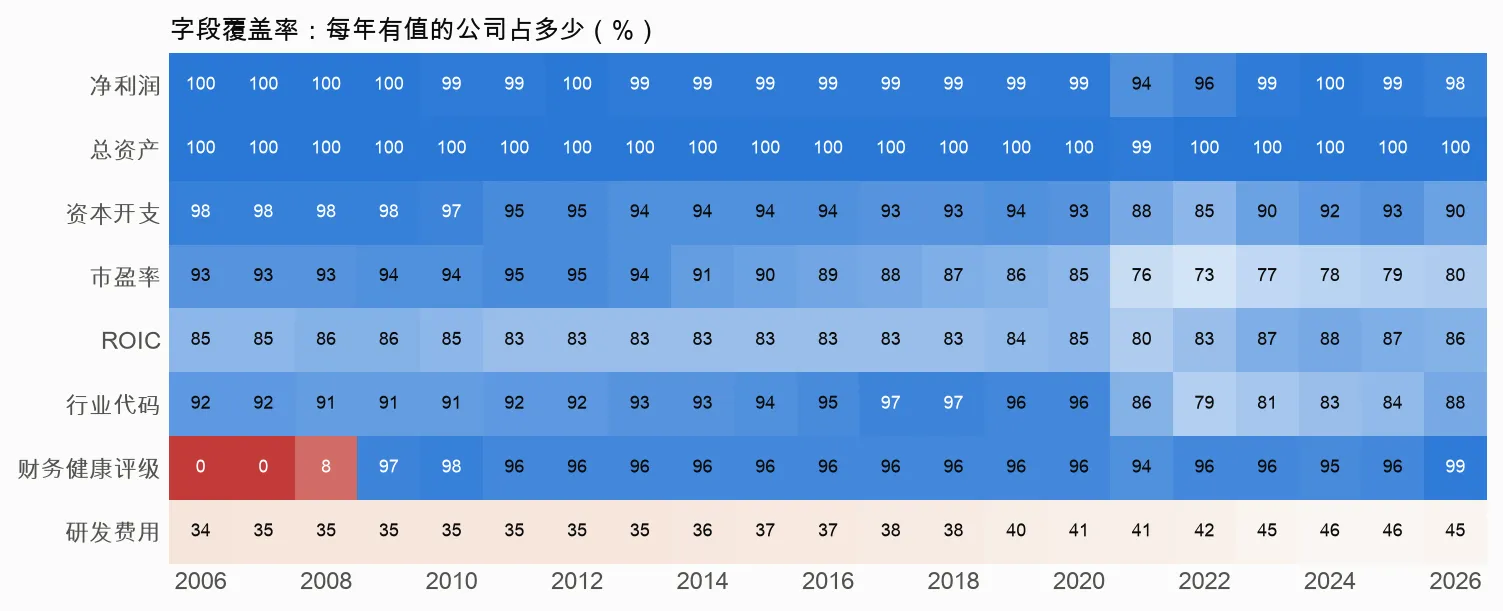
净利润、总资产这类报表字段几乎全有;财务健康评级 2008 年 9 月才开始有;研发费用只有 35–46% 的公司有值,而且有一家已知的大公司没通过“研发费用在合理范围内”的检查,用之前要单独查;行业代码在 2021–2025 年只有约 80%(新上市的公司多)。一个因子如果用到早年没有的字段,它在早年的“效果”其实是在少数公司上算出来的。
3. Morningstar 的“盈利收益率”在早年提前了约两个月。 这是更早的一个 notebook 发现的:2006–2012 年,Morningstar 直接给的估值比率,比用财报自己算的同一个比率早约两个月就变了,像是按报告期而不是按公布日记的。用了它,回测就偷看了两个月的未来。结论是尽量用财报字段自己算比率,不用现成的比率字段。
4. 和旧方法对账。 同一个问题(前 500 家公司里,评级最高那一档有多少跑赢 SPY),用新库算出的数和之前 notebook 自己拉数据算的只差 0.1 个百分点(45.0% 对 45.1%)。新旧两条路对得上,说明库没有建歪。
学到的几件事
- 研究和取数据要分开。 数据整理一次、检查一次,之后每个研究只回答它自己的问题。研究 notebook 短了,也更容易让人(包括我自己)读懂。
- 在 QC 上,用回测建库比用 notebook 拉数据稳。 回测按日期走,天然是“当时能看到的数据”,内存也可控。代价是要摸清回测节点的内存规律,按字段分组、按年份分段。
- “被杀”不会告诉你原因。 没有日志的
Killed基本就是内存。先加一个只量内存的小开关,比猜快得多。 - 检查项要在看结果之前定好,并且对不上的要写下来,不要悄悄改阈值让它通过。这次两个没通过的检查,最后都变成了要写进研究约定的规则。
- 字段的覆盖率和日期要先查。 现成的比率字段可能日期不对,有的字段早年是空的。这些都不会报错,只会让回测结果悄悄变好看。
下一篇讲怎么定义 S/A/B/C/D:为什么目标从“下个月涨不涨”改成“一年后跑赢 SPY”,为什么“什么都不做”的成绩是 43.8% 而不是 50%,以及为什么要先给股票池加一个成交额门槛。