如何设计一个像 Speechify 那样的 PDF 朗读服务
从需求和容量估算开始,定义核心实体和接口,画出高层架构,再逐个深入:大 PDF 怎么分句、点哪读哪怎么实现、上传高峰怎么扛、高并发下怎么避免重复生成语音。这是我做 PDF 朗读产品时的系统设计过程。
English version: How to Design a PDF Text-to-Speech Service Like Speechify
文本转语音(TTS)服务已经成为让内容更易获取的常用工具,对更愿意听而不是读的用户很方便。最知名的 TTS 平台之一是 Speechify,它把包括 PDF 在内的数字文本转成高质量音频。我动手做一个类似 Speechify 的 PDF 朗读服务时,遇到了不少挑战,也看到了机会。这篇文章把我做系统设计的过程走一遍:从理解用户需求,到选技术栈,再到怎么扩展。
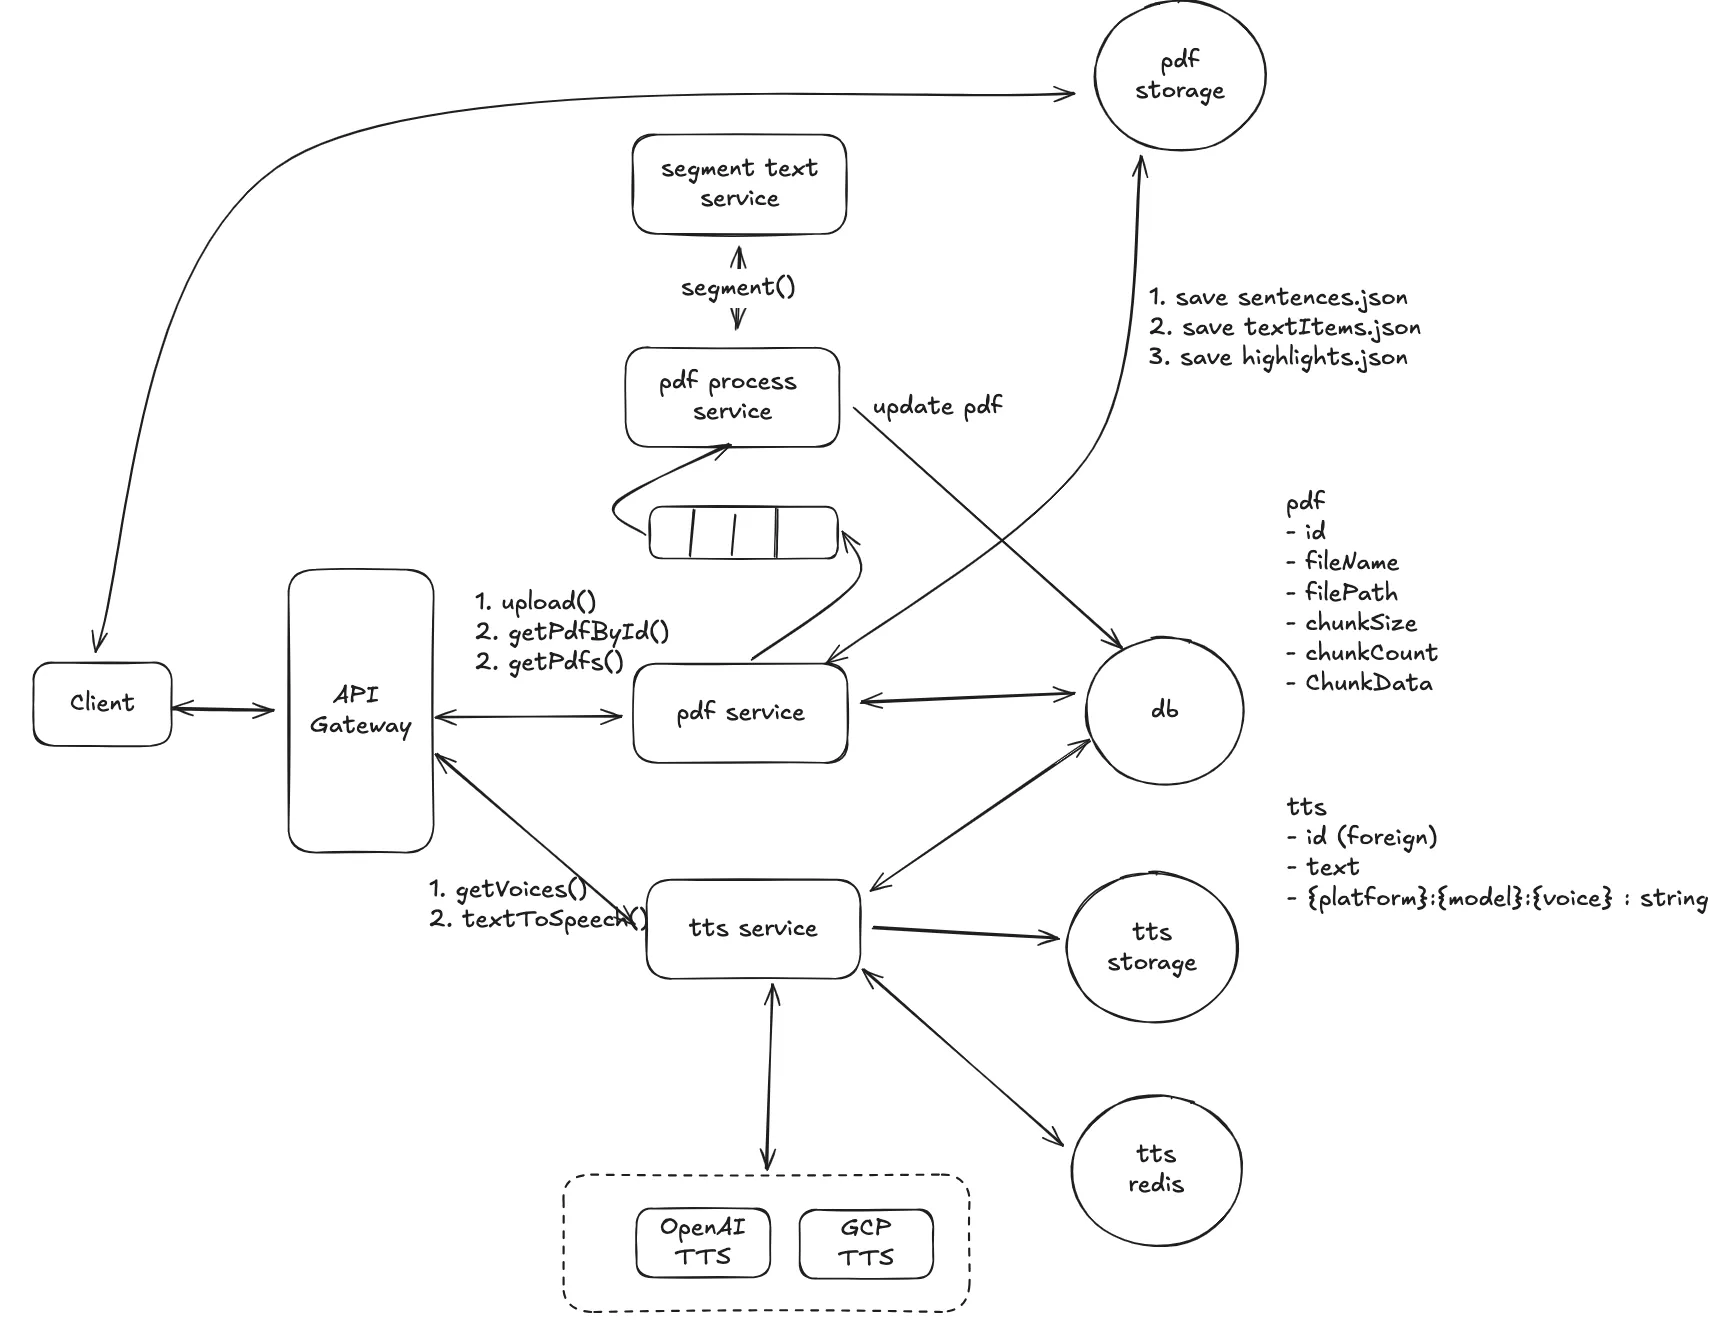
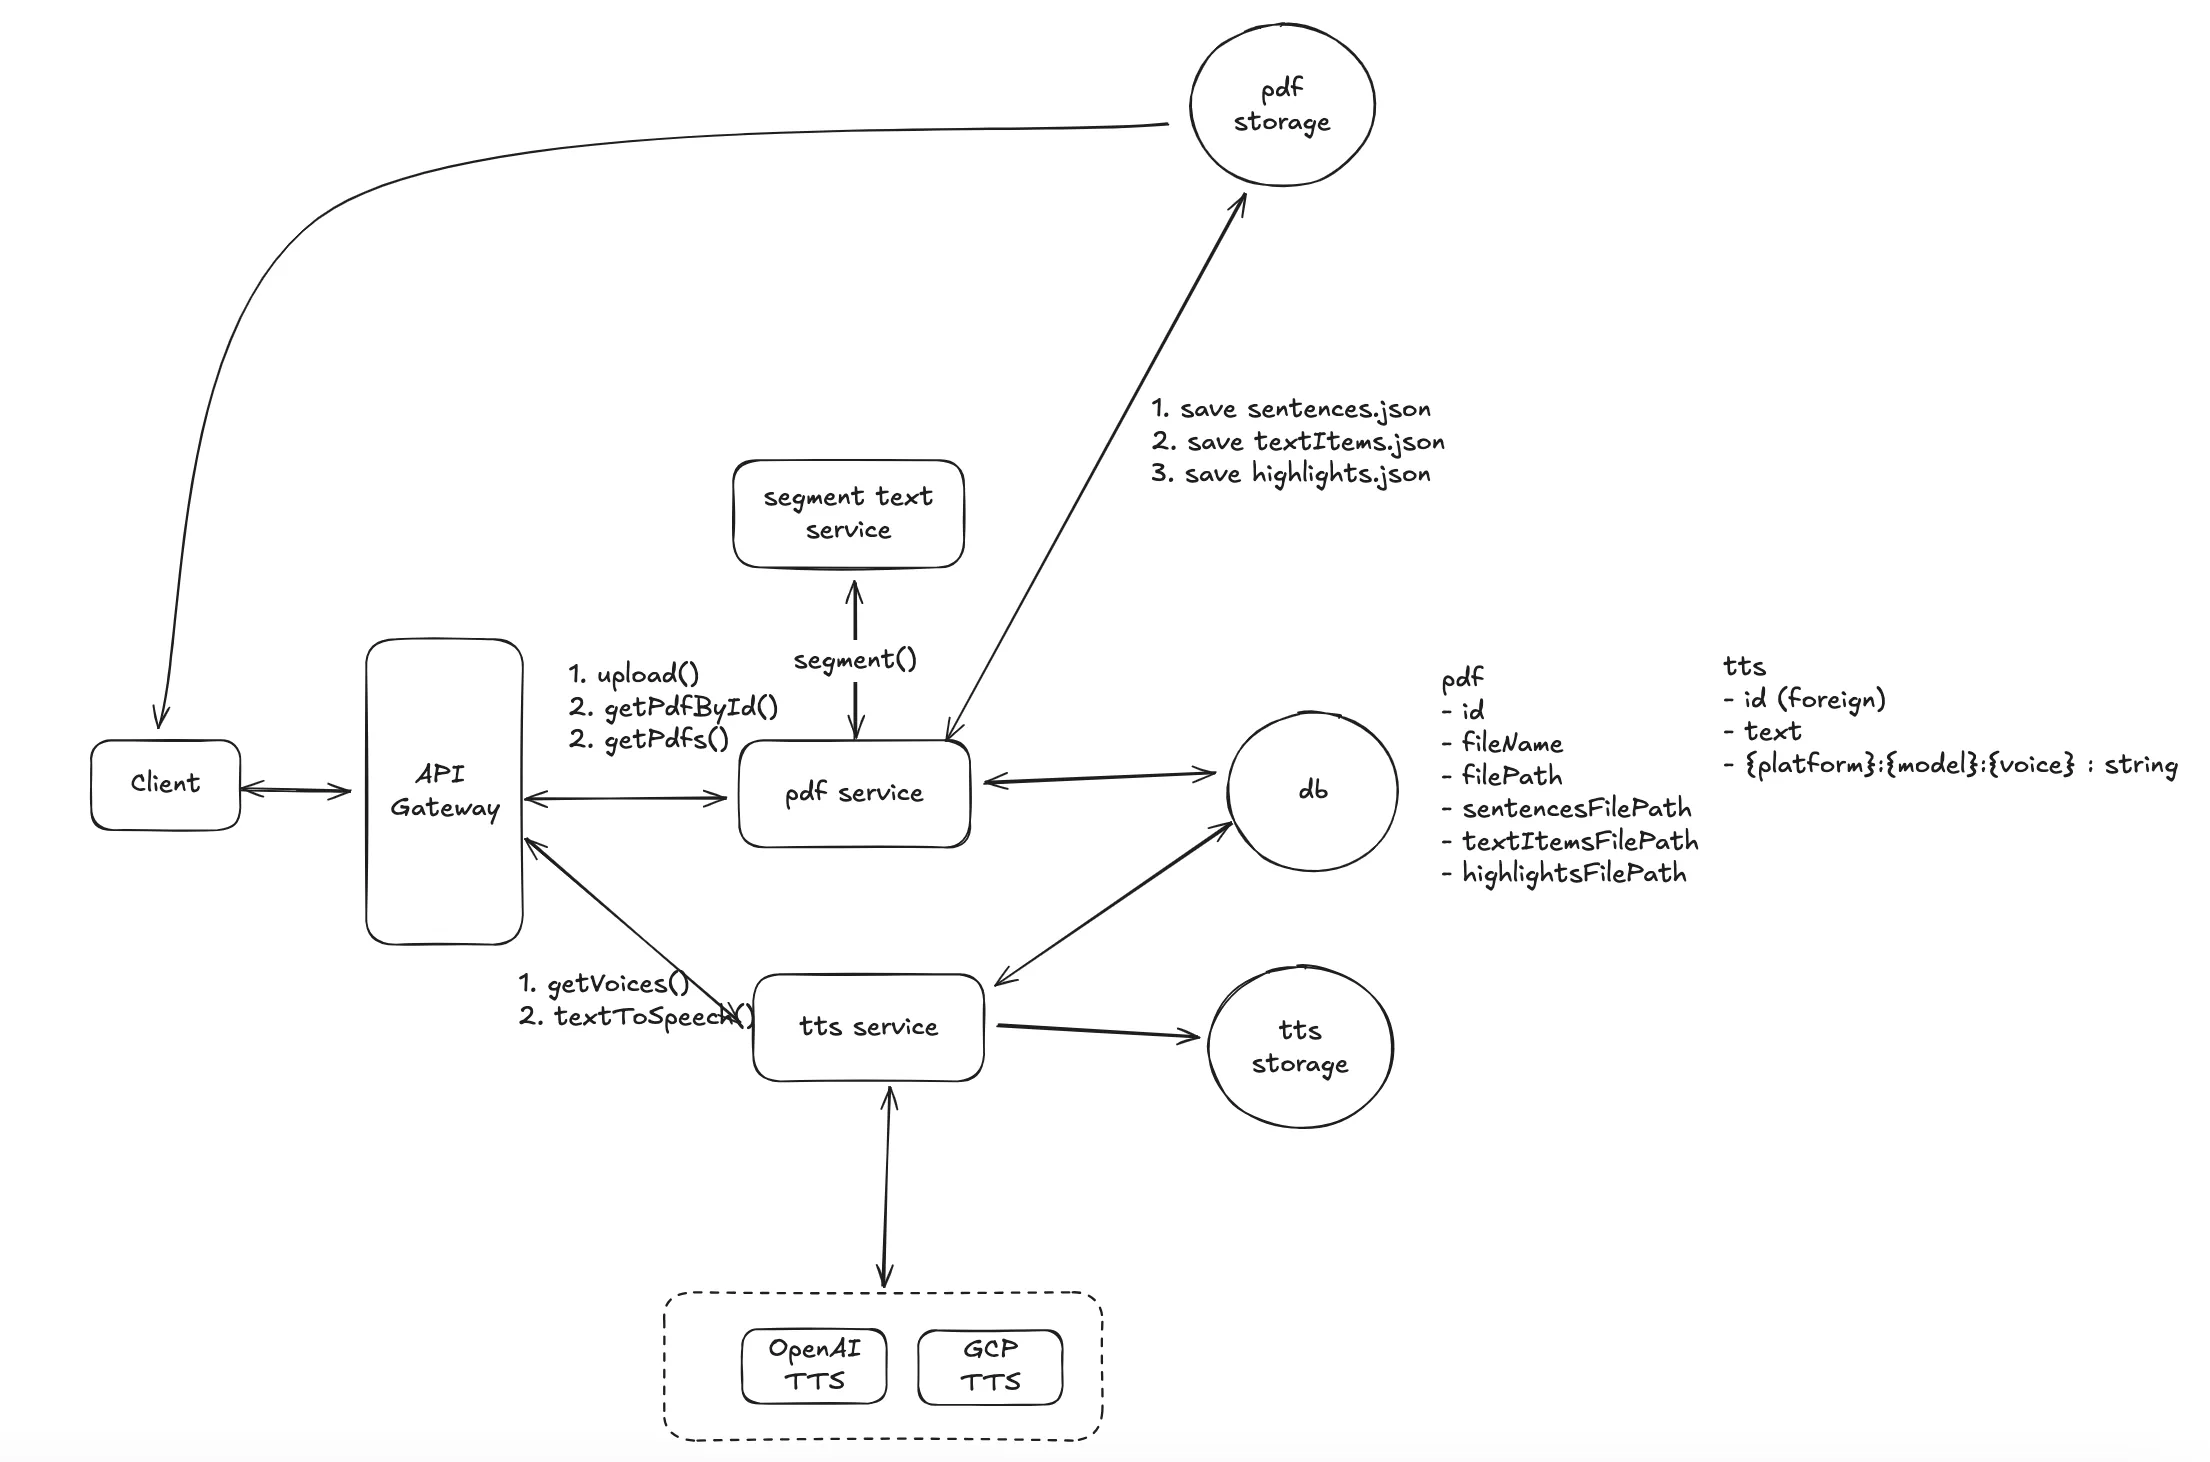
最终的高层架构图如下:
理解问题
功能需求
在进入架构和设计之前,先明确这个服务要提供什么。我定的核心功能:
- 用户可以上传 PDF 文件。
- 用户可以看到已上传的 PDF 列表,并预览单个文件。
- 用户点一个按钮,系统从头开始朗读。
- 用户点击 PDF 里的任意一句文本,系统从这句开始朗读,并自动继续读后面的内容。
- 用户可以调整语音和播放速度。
非功能需求
- 系统必须能快速处理大 PDF,几百 MB 的文件也要在几秒内处理完。
- 开始朗读的延迟要极低,100 毫秒以内,连续朗读时没有明显停顿。
- 支持 100 万日活用户。
- 高可靠,99.99% 可用性,可用性优先于一致性。
容量估算
容量估算帮我们提前评估系统规模,在给定假设下需要多少计算和存储资源,也帮助设计扩展性、考虑成本、评估性能和可靠性。
假设
- 100 万日活用户。
- 每个用户每天上传一个 1MB 的文档。
- 每个用户每天请求 5 次 PDF 列表和 PDF 详情。
- 每个用户每天听 1 小时 TTS。
估算
- 文档列表请求:
- 每个用户每天请求 5 次。
- 100 万用户/天 × 5 次/用户 = 500 万次/天
- 500 万次/天 ÷ 100,000 秒/天 ≈ 50 次/秒
- 文档详情请求:
- 同样每天 5 次。
- 500 万次/天 ÷ 100,000 秒 ≈ 50 次/秒
- 文档上传:
- 每个用户每天上传 1 个文档(1MB)。
- 100 万次/天 ÷ 100,000 秒 ≈ 10 次/秒
- TTS 音频生成:
- 1 小时音频约 50,000 个字符(假设一句 100 个字符)。
- 50,000 字符 ÷ 100 = 每个文档 500 句
- 每个用户每天 500 次 TTS 请求
- 500 次/用户 × 100 万用户/天 = 5 亿次/天
- 5 亿次/天 ÷ 100,000 秒 = 5,000 次 TTS 请求/秒
存储需求
- PDF 存储:
- 100 万用户/天 × 1MB × 365 天/年
- 合计 3.65 亿 MB = 每年 365 TB
- 音频存储:
- 假设每句 TTS 音频 0.1MB:
- 100 万用户/天 × 500 句 × 0.1MB × 365 天/年
- 合计 每年 18,250 TB(每天 5,000 万 MB × 365)
搭建
定义核心实体
定义处理 PDF、生成 TTS 输出、管理可用语音所涉及的核心实体。
id:PDF 的唯一标识。fileName:文件名。filePath:存储位置(云存储路径或本地路径)。
TTS
id:TTS 的唯一标识。text:要转成语音的文本。{platform}:{model}:{voice}:平台、模型、语音组合而成的唯一字符串标识(比如 AWS:Polly:Neural、Google:Standard:EnglishA)。
Voice
id:语音的唯一标识。platform:TTS 平台(比如 AWS Polly、Google Cloud Text-to-Speech)。model:语音模型(Neural、Standard 等)。voice:具体的语音选项(比如 “Joanna”)。languageCode:语言代码(比如 “en-US”)。voiceName:人类可读的语音名称。
API 或系统接口
定义以下 REST 接口,处理 PDF 上传、获取可用语音、提交 TTS 请求。
PDF 管理 API
- 上传 PDF
- 接口:
POST /docs - 请求体:
{ "fileName": "example.pdf", "filePath": "/uploads/example.pdf" }- 响应:成功或错误信息,附上传 PDF 的
id。
- 接口:
- 列出所有 PDF
- 接口:
GET /docs - 响应:
[ { "id": "1", "fileName": "example.pdf", "filePath": "/uploads/example.pdf" }, ] - 接口:
- 按 ID 获取 PDF
- 接口:
GET /docs/:id - 响应:
{ "id": "1", "fileName": "example.pdf", "filePath": "/uploads/example.pdf" } - 接口:
TTS API
- 列出可用语音
- 接口:
GET /tts/voices - 响应:
[ { "id": "1", "platform": "AWS Polly", "model": "Neural", "voice": "Joanna", "languageCode": "en-US", "voiceName": "Joanna" }, ] - 接口:
- 提交 TTS 请求
- 接口:
POST /tts - 请求体:
{ "text": "Hello, welcome to our platform!", "platform": "AWS Polly", "model": "Neural", "voice": "Joanna", "languageCode": "en-US" }- 响应:成功信息附生成的 TTS 文件
id,或错误信息。
- 接口:
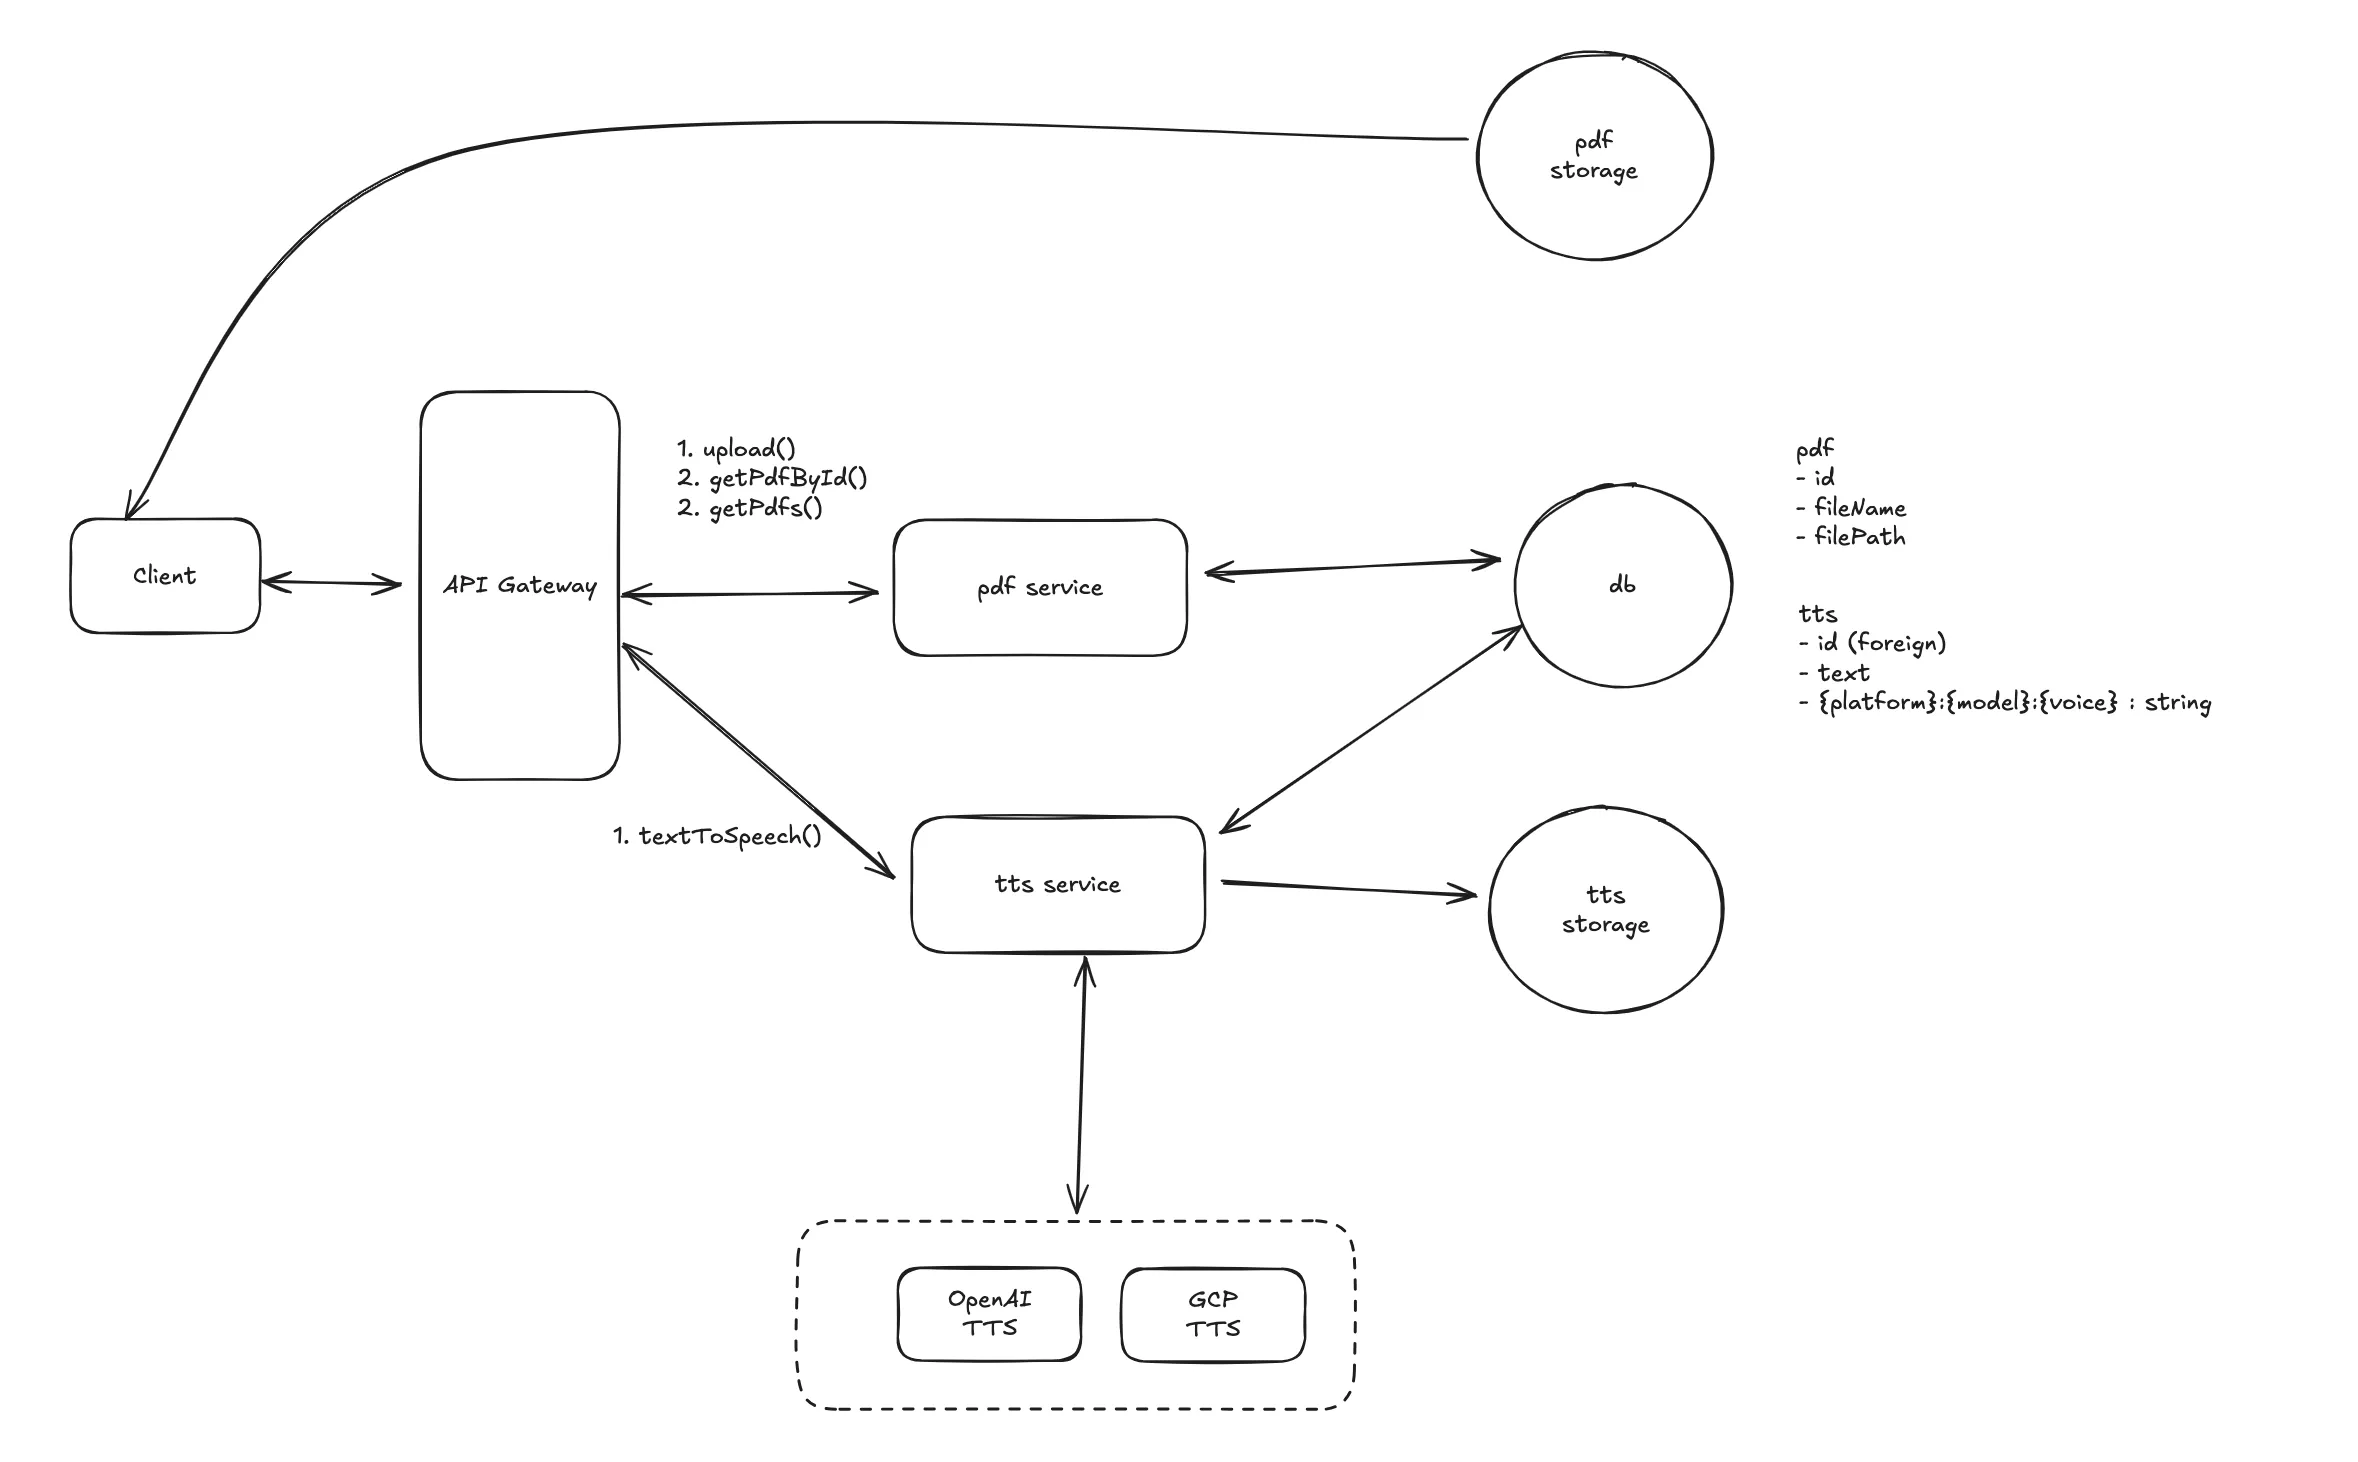
高层设计
从一个简单场景开始。假设一个 PDF 只有一页,每一行是一句完整的话,比如:
Hello Everyone. I'm Allen. Nice to meet you.1. 基本流程
- 第 1 步:把 PDF 上传到存储(比如 AWS S3)。
- 第 2 步:存储返回文件路径。
- 第 3 步:调用后端的
upload()接口,把 PDF 信息(fileName、filePath)存进数据库。 - 第 4 步:客户端调用
getPdfs()获取 PDF 列表。 - 第 5 步:客户端调用
getPdfById()获取某个 PDF 的详情,包括文件路径。 - 第 6 步:客户端用 react-pdf 库渲染 PDF,传入文件路径。
- 第 7 步:客户端用 pdfjs-dist 解析 PDF 内容,提取所有句子。
- 第 8 步:对每一句调用
textToSpeech()接口,拿到 TTS 音频地址。 - 第 9 步:直接用这个地址播放音频。
2. TTS 缓存机制
为了优化系统,可以缓存 TTS 结果。调用 textToSpeech() 时,用句子的 MD5 哈希生成一个唯一 ID,相同的输入就能复用同一个音频文件,不用重新生成。不同的平台、模型或语音会生成不同的文件路径,但归在同一个 ID 下。
例如:
{
   "id": "jAR8eju7eZS9LN5RP9TP77jG3lnnEsNQaZ_QAspBo",
   "text": "Hello Everyone. I'm Allen. Nice to meet you",
   "google-standard-EnglishA": { "filePath": "/tts/google/EnglishA.mp3" },
   "openai-tts-1-alloy": { "filePath": "/tts/openai/Alloy.mp3" }
}- 键
"jAR8eju7eZS9LN5RP9TP77jG3lnnEsNQaZ_QAspBo"是文本的 MD5 哈希。 - 平台、模型、语音的组合(
google-standard-EnglishA、openai-tts-1-alloy)对应不同的音频文件路径。
这样,用户用相同的 TTS 参数请求同一句话时,系统直接从存储取缓存结果,不用重新生成,减少重复的 TTS 生成,节省时间和算力。
3. PDF 服务和 TTS 服务分离
出于扩展性考虑,把 PDF 服务和 TTS 服务分开:
- 从容量估算可以看到,TTS 请求的并发量大约是 PDF 相关操作的 500 倍。
- TTS 服务需要的水平扩展远多于 PDF 服务。
- 两个服务各自独立运行,各有各的扩展需求。
4. 数据库选型
考虑到:
- 表之间没有复杂关系(不需要外键和 join)。
- TTS 服务因为高并发会产生大量写操作。
MongoDB 或 DynamoDB 这类 NoSQL 数据库更适合存 PDF 和 TTS 数据。NoSQL 针对高写入吞吐优化,也容易水平扩展。
这个高层设计给出了一个简单且可扩展的架构:把 PDF 服务和 TTS 服务分开以应对不同的并发量;用 MD5 哈希做键缓存 TTS 结果,避免重复生成;用 NoSQL 保证高写入吞吐。这个架构可以很容易地扩展到更多场景和更高负载。
可能的深入讨论
1. 大 PDF 文件怎么处理
第一版设计在处理大 PDF 时有个明显问题:如果客户端一次性请求整个大 PDF 的 TTS,延迟会非常高。解决办法是把文本切成小块。有两种可能的方案:
方案一:客户端提取文本并分句
- 流程:
- 客户端从 PDF 提取全部文本,用正则按标点(句号、问号、感叹号)切成句子。
- 每一句作为单独的请求发给服务端的 TTS 接口转成音频。
- 优点:
- 处理简单:逻辑相对简单,服务端不用改。
- 请求更小:TTS 请求更小更快,服务端每次处理时间更短。
- 缺点:
- 正则不准:正则分句不一定准确,比如 “Mr.”、编号 “1.” 之类的特殊情况会切错。
- 每次重新处理:每次打开文档客户端都要重新解析和分句,可能造成延迟或卡顿。
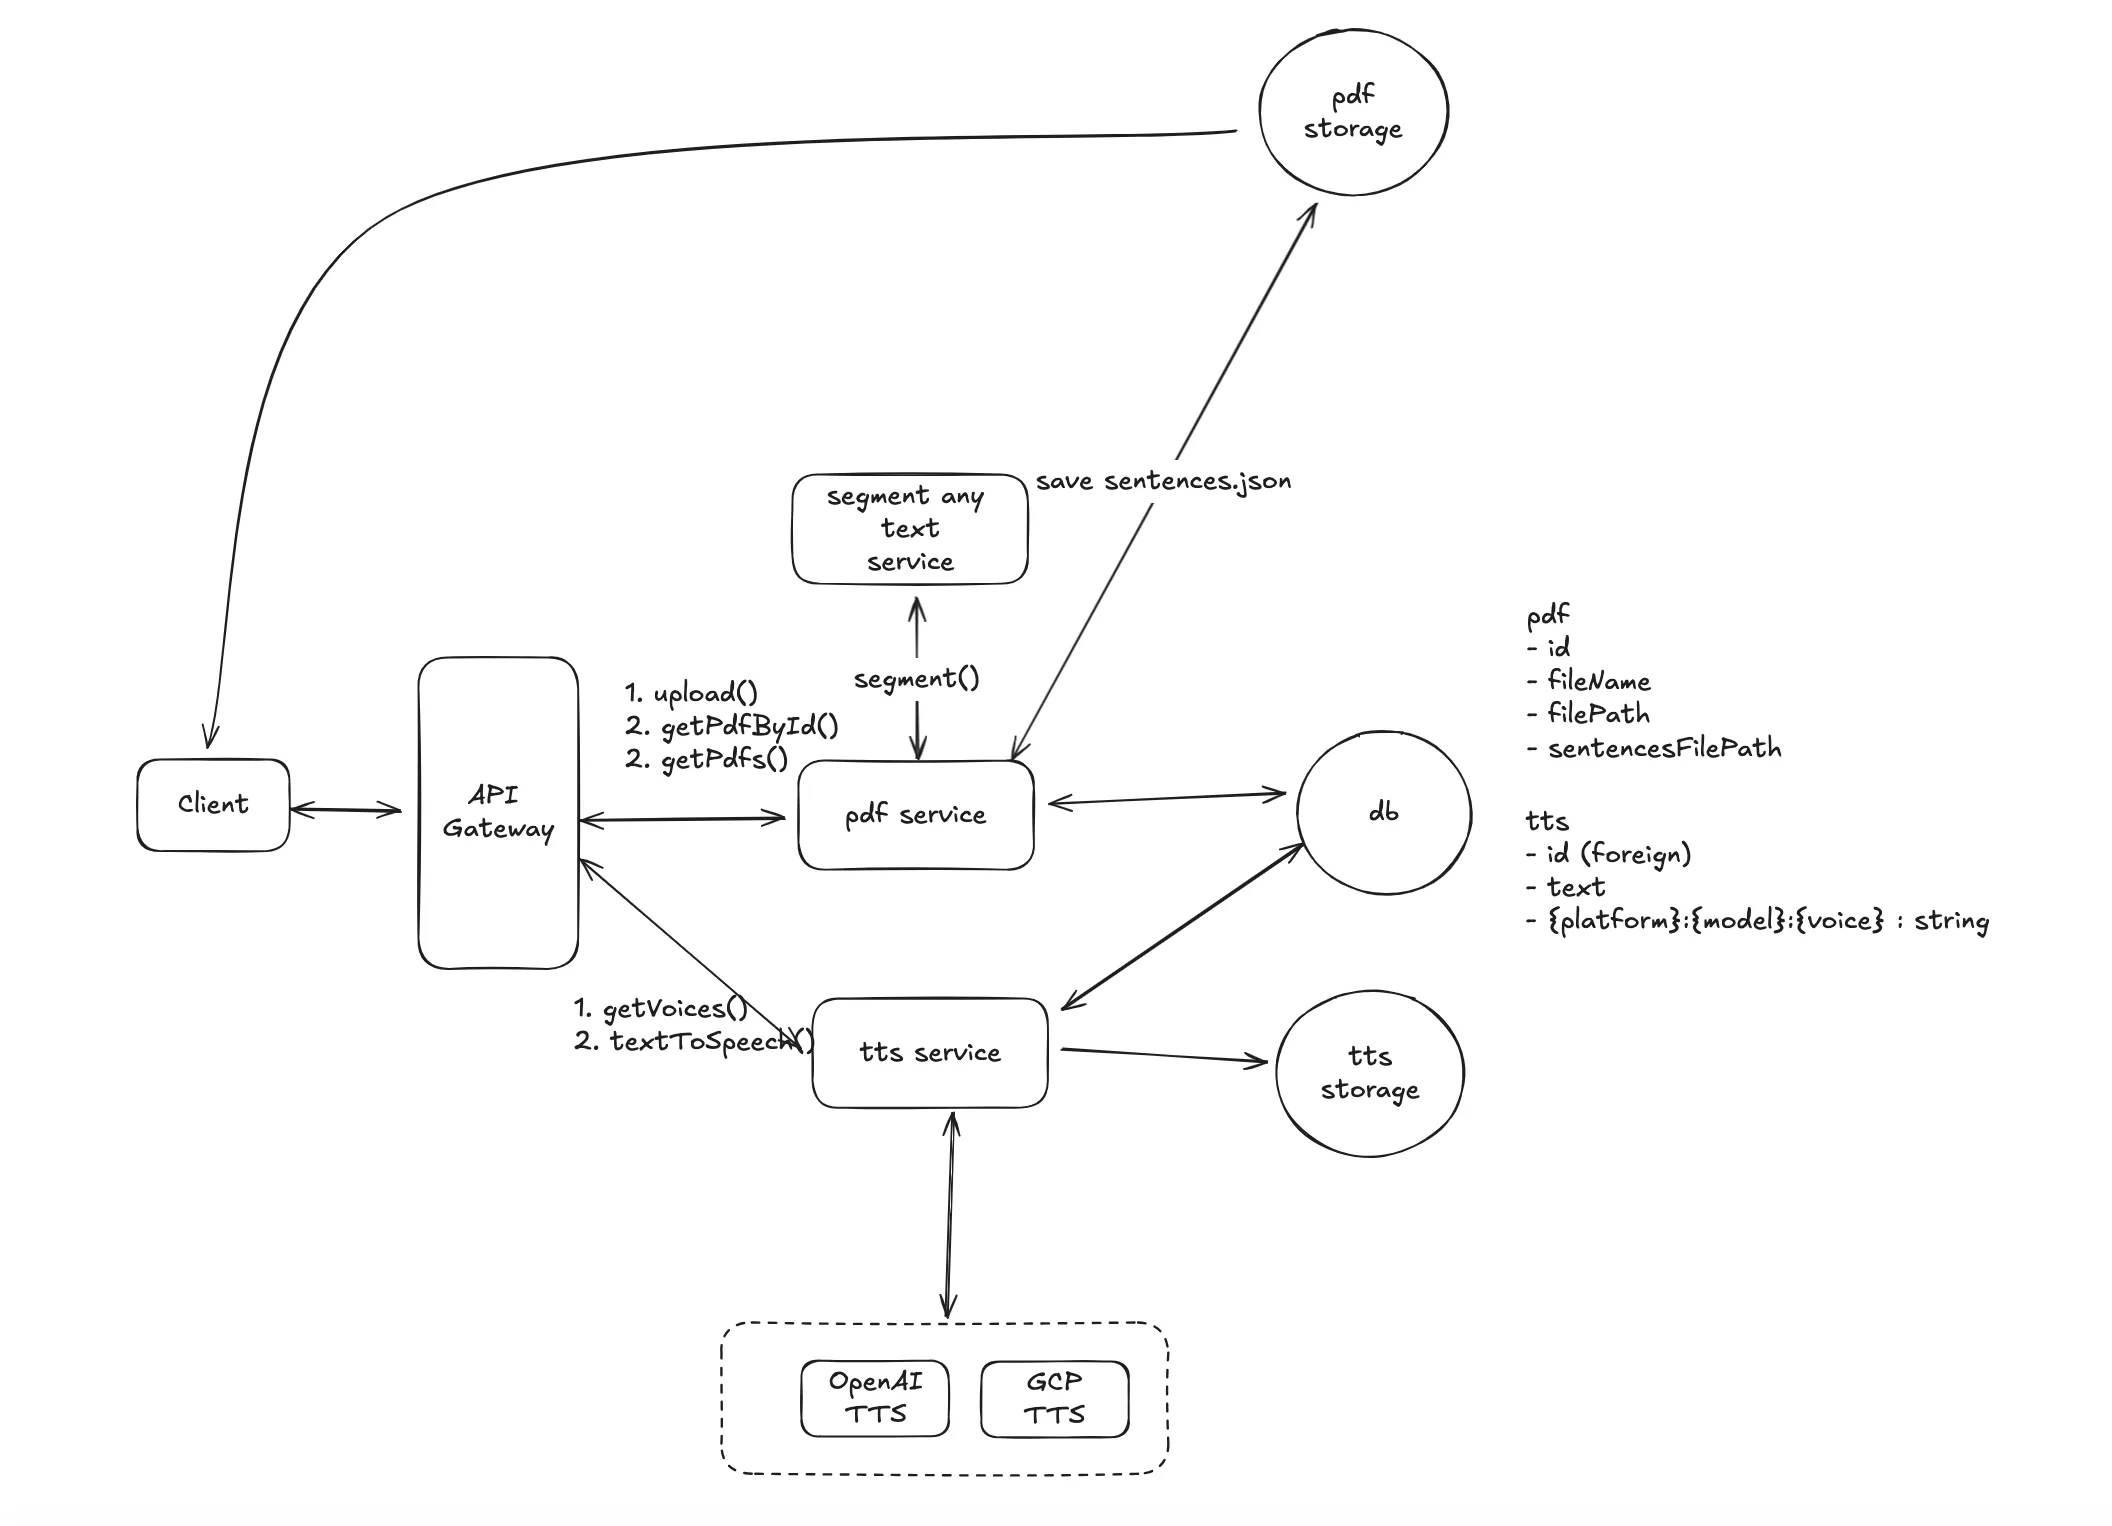
方案二:上传时在服务端分句
- 流程:
- 用户上传 PDF 时,服务端立刻处理 PDF 并提取全部文本。
- 服务端用一个分句服务把文本切成正确的句子。
- 分好的句子存成一个
.json文件,放在云存储里。 - 客户端请求某个 PDF 的 TTS 时,直接取这个预处理好的
.json,每一句单独处理。
什么是分句服务
- 分句服务是一个用自然语言处理(NLP)技术把任意文本切成句子的工具,比简单正则准确得多。它能处理复杂句式、缩写和标点规则,给出更可靠的分句结果。
- 例子:对于 “Dr. Smith is here. She arrived at 10:00 a.m. Can you see her?”,一个合格的 NLP 分句工具会正确理解 “Dr.” 和 “a.m.”,不会切错。
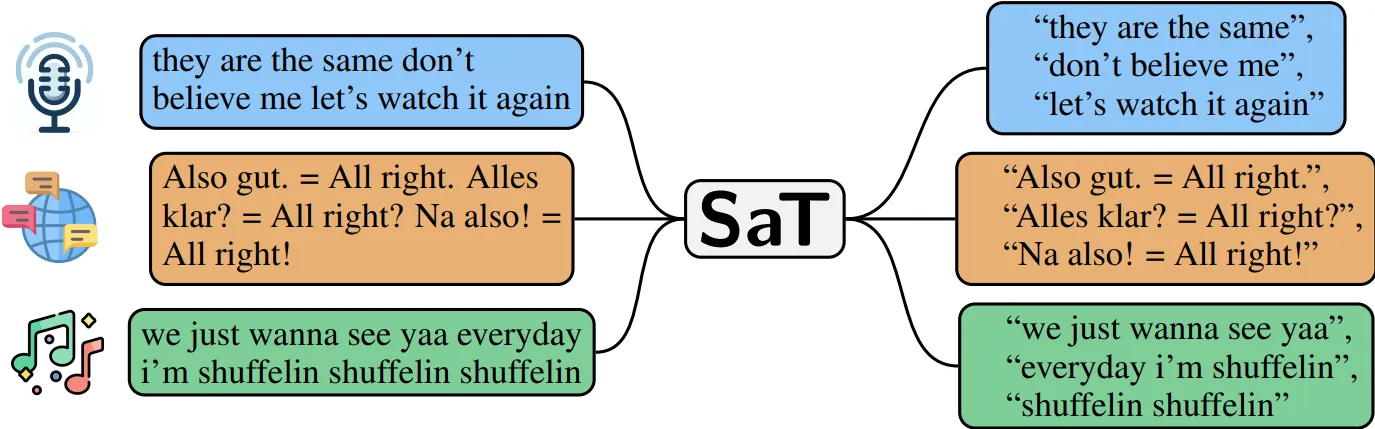
可用的 NLP 分句库:
- spaCy:流行的 NLP 库,提供分句能力。
- NLTK:另一个强大的文本处理和分句库。
- Stanford CoreNLP:一套 NLP 工具,包含分句功能。
服务端分句的优点
- 处理高效:PDF 只在服务端处理一次,之后客户端直接从
.json取分好的句子,减轻客户端负担,加快 TTS。 - 分句准确:用 NLP 分句服务,错误比正则少得多。
- 性能更好:分句只在上传时做一次,后续请求只是取预处理好的数据,更快。
服务端分句的缺点
- 复杂度增加:需要在上传流程里多一个 NLP 分句服务。
- 存储增加:分好句的文本要和原 PDF 一起存,存储略增。
对于处理大量 PDF 的系统,方案二(服务端分句)更高效、更可扩展。它避免了客户端的重复处理,保证分句准确,TTS 生成更快更顺。虽然前期要多搭一个分句服务、多存一份 .json,但性能和准确性上的长期收益让它成为更好的选择,尤其是高流量系统。
更新后的高层架构图:
2. 怎么实现“点哪读哪”
读 PDF 的时候,用户往往不想从头开始听,而是想点击文档里的任意一句,从那里开始。实现这个功能,需要把 PDF 里的文本准确映射到屏幕上的位置。一步一步来:
第 1 步:用 pdfjs-dist 提取文本和位置
先解析 PDF,提取文本内容和位置数据。pdfjs-dist 提供这样的结构:
TextItem 数据结构
{
  text: 'Hello',
  transform: [300, 0, 0, 10, 300, 500], // 位置 (x: 300px, y: 500px)
  width: 100, // 文本框宽度(像素)
  height: 10  // 文本框高度(像素)
},
{
  text: 'World',
  transform: [300, 0, 0, 10, 0, 300],
  width: 100,
  height: 10
}
这个例子里,“Hello” 位于 (x: 300px, y: 500px),宽 100px,高 10px。提取出来的文本和位置数据,是确定每个词或每句话在页面上位置的基础。
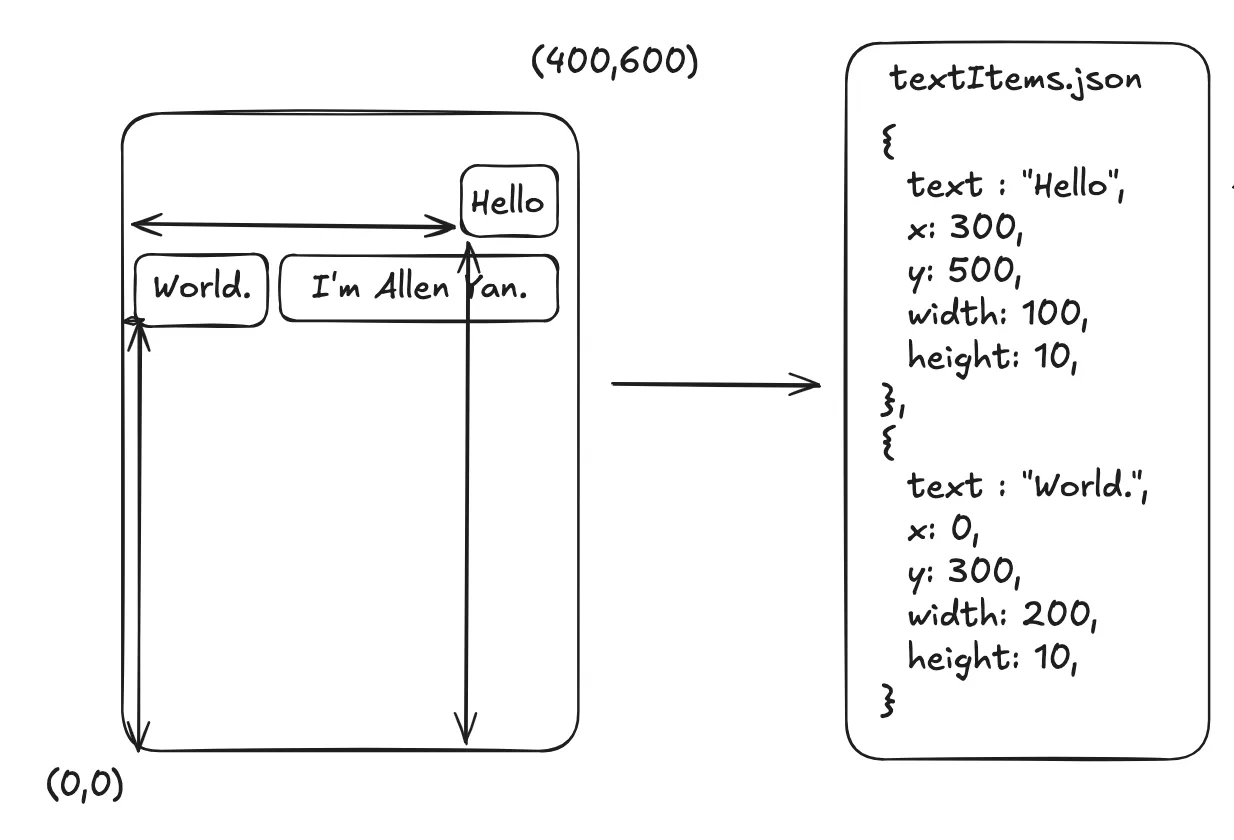
第 2 步:生成句子和位置的映射
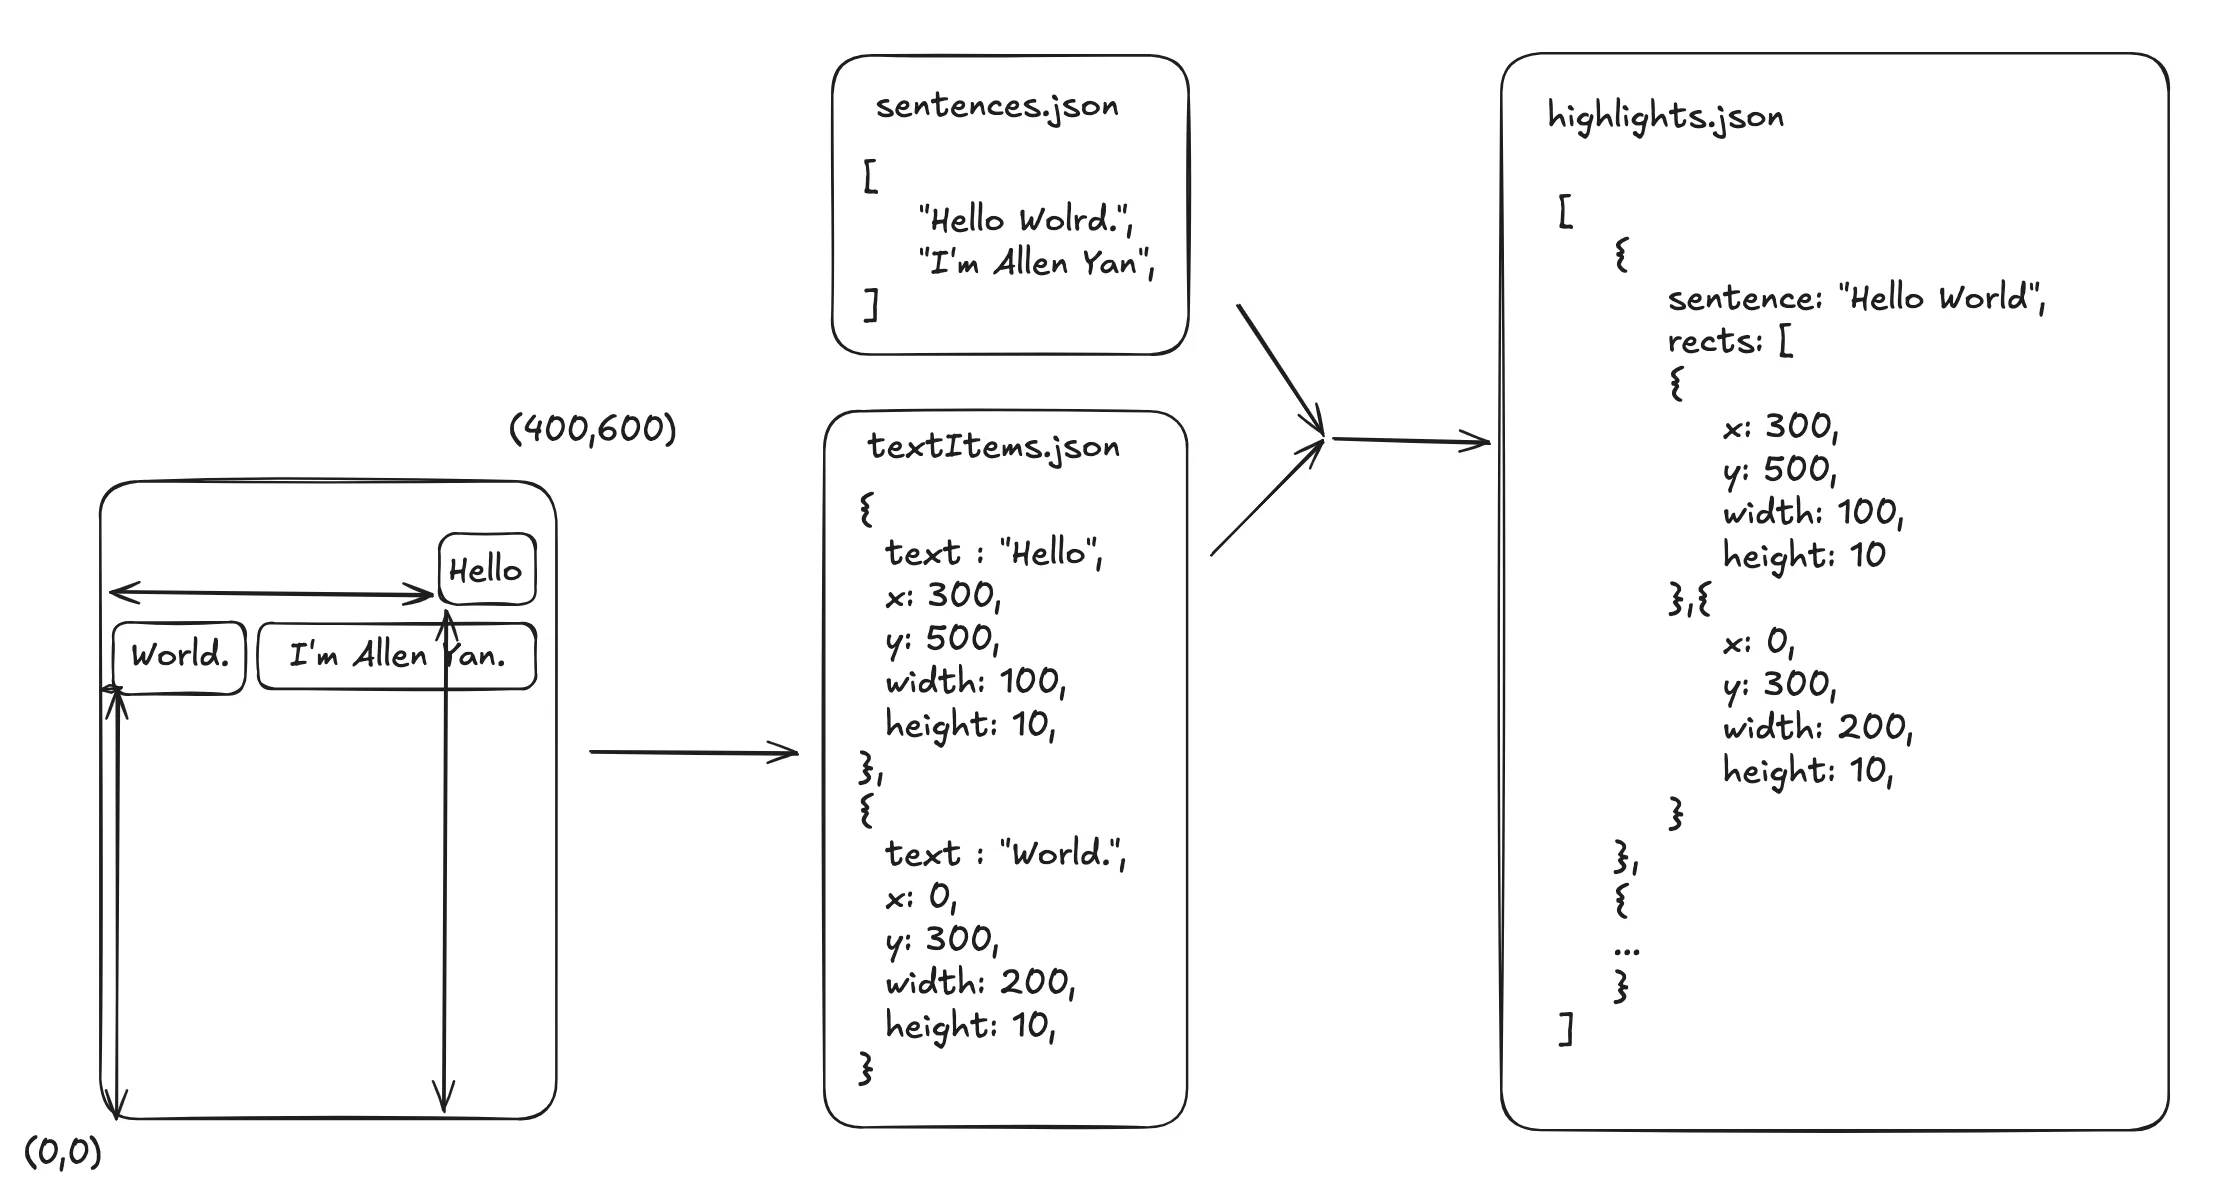
要实现点哪读哪,需要把每一句映射到 PDF 页面上的准确位置。把句子文本(来自 sentences.json)和从 PDF 提取的位置信息(来自 textItems.json)结合起来:
sentences.json:PDF 里的每一句,已经切成 TTS 用的小块。textItems.json:用 pdfjs-dist 提取的每个词或短语的精确位置。
第 3 步:生成 highlights.json
用 sentences.json 和 textItems.json 生成 highlights.json,把每一句映射到它在 PDF 上对应的矩形坐标(x、y、宽、高)。
highlights.json 结构
[
  {
    "sentence": "Hello Everyone.",
    "rects": [
      {
        "x": 300,
        "y": 500,
        "width": 100,
        "height": 10
      },{
        "x": 0,
        "y": 300,
        "width": 100,
        "height": 10
      }
    ]
  },
  {
    "sentence": "I'm Allen.",
    "rects": [
      {
        "x": 320,
        "y": 520,
        "width": 120,
        "height": 10
      }
    ]
  }
]
在这个结构里,每一句都有一组坐标,定义它出现在页面的哪里。这些坐标可以用来在文档上创建可点击区域。
第 4 步:叠加高亮和可点击区域
有了 highlights.json,下一步是在 PDF 上盖一层透明图层,用来捕获点击和显示高亮:
- 高亮层:用 HTML/CSS 在 PDF 查看器上创建一个透明层。对每一句,按
highlights.json里的坐标创建一个不可见的可点击框。 - 悬停和点击事件:用户悬停或点击某一句时,高亮区域变为可见,并触发对应的 TTS 播放。
高亮框的 CSS
.highlight-box {
  position: absolute;
  background-color: rgba(255, 255, 0, 0.3); /* 黄色高亮 */
  border: 1px solid rgba(255, 255, 0, 0.7);
  cursor: pointer;
}
处理点击的 JavaScript
document.querySelectorAll('.highlight-box').forEach(box => {
  box.addEventListener('click', function() {
    const sentence = this.getAttribute('data-sentence');
    playTTS(sentence); // 用被点击的句子调用 TTS
  });
});
这样用户就可以点击 PDF 里任何高亮的文本,从那一句开始朗读。
这个方案的优点
- 精确选句:用户可以点任意一句从那里开始听,不必从头听。
- 位置准确:用 pdfjs-dist 提取的文本数据,保证可点击区域和 PDF 上的文本位置完全对应。
实现 PDF 的点哪读哪,需要把每一句映射到文档上的精确位置。用 pdfjs-dist 提取文本和位置数据,生成存有每句坐标的 highlights.json,用户就可以点击文档任意位置触发 TTS 播放。再配合高效的 TTS 缓存,用户体验流畅、响应快。
3. 上传高峰怎么处理
容量规划时我们估算的平均流量是每秒 1 万次 PDF 上传,高峰可能到每秒 3 万。处理一个 PDF 要几秒钟,怎么设计才能既保证低延迟又保证高吞吐?两种可能的方案:
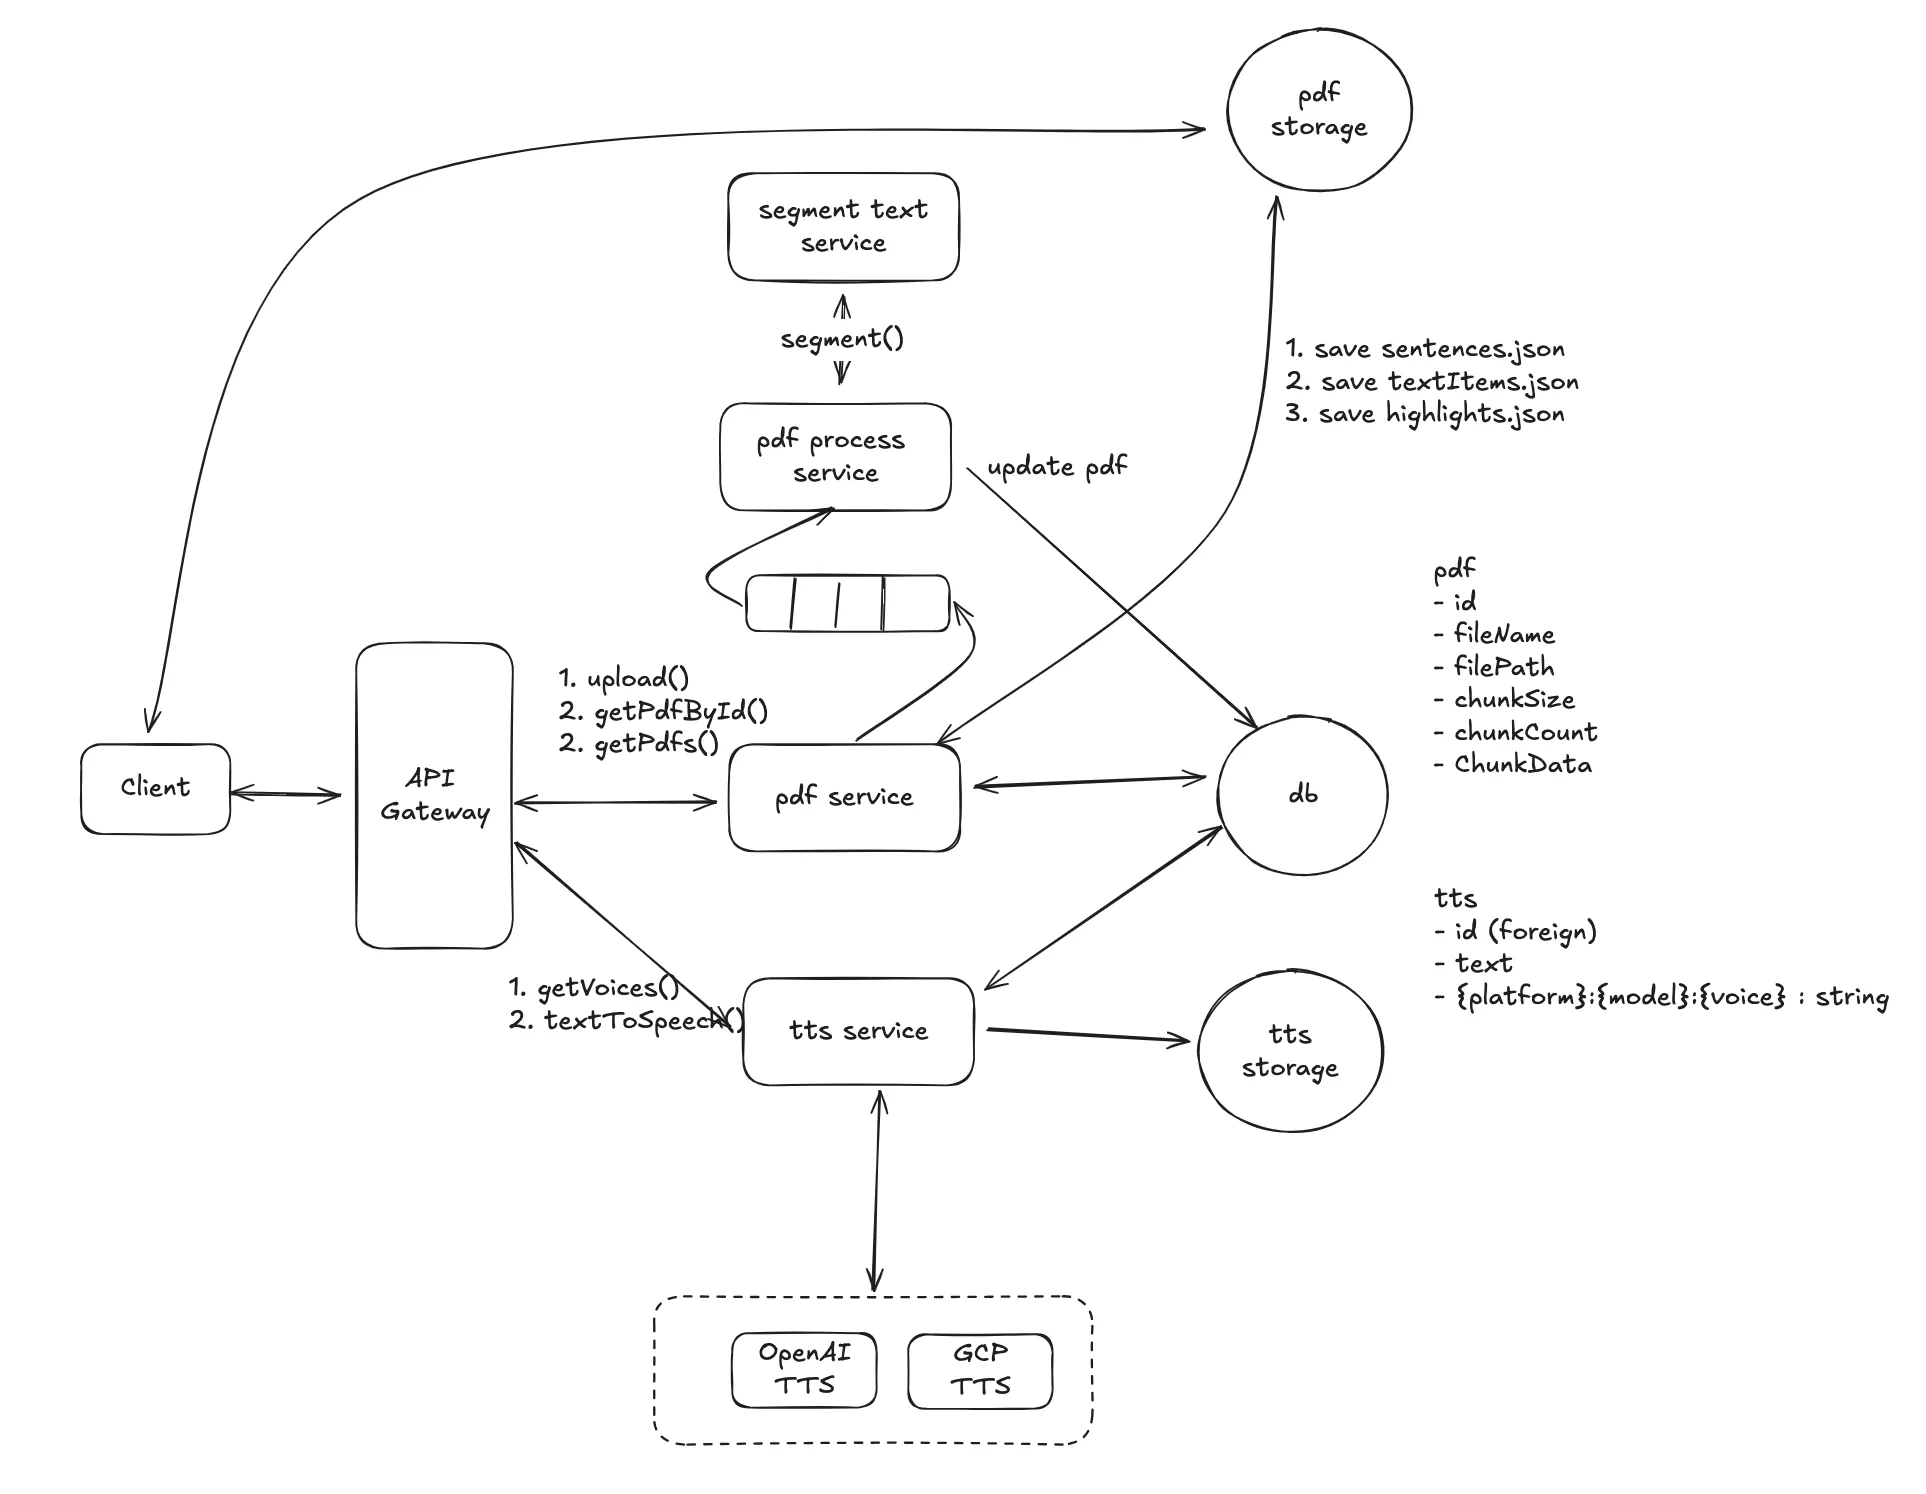
方案一:用异步队列解耦 PDF 处理
把 PDF 服务和 PDF 处理服务解耦。处理服务可以水平扩展,流量高峰时增加实例来应对。
架构如下:
- PDF 服务:用户上传 PDF 后立即存储,并向 Kafka(或其他消息中间件)队列发一条消息,带上文档元数据和文件路径。
- PDF 处理服务:订阅 Kafka 队列,异步处理上传的 PDF:提取文本,生成高亮,为后续操作做准备。
- 进度跟踪:客户端用轮询或 WebSocket 查询文档处理状态。系统实时更新进度,文档状态从 pending 到 processing,全部完成后变为 completed。
优点:
- 水平扩展:处理服务可以独立扩展,高效应对流量突增。
- 异步处理:PDF 处理不阻塞上传流程,用户得到更快的响应。
缺点:
- 实时监控:跟踪文档状态、管理用户对处理时间的预期,增加了一些复杂度。
方案二:分块处理
把 PDF 拆成小块独立处理。比如每 10 页一块。每处理完一块就更新文档元数据,文档状态从 pending 变为 processing。
- 分块:PDF 上传后切成若干块,每块包含一定页数(比如 10 页)。
- 并行处理:每块独立并行处理。一块处理完,对应的 doc.state 就从 pending 更新为 processing,表示部分可用。
- 客户端渲染:客户端不需要一次渲染整个文档。它按当前页码和块索引请求高亮数据。比如用户在看第 21 页,系统知道要渲染 chunkIndex = 2,只取那一块的高亮。
优点:
- 反馈更快:用户不用等整个文档处理完就能开始交互,几乎立刻就能看和用文档的一部分。
- 资源利用高效:大 PDF 拆成小块并行处理,整体吞吐更高,处理时间更短。
缺点:
- 复杂度增加:分块以及管理文档和高亮的部分状态,让后端处理和客户端逻辑都更复杂。
4. 高并发下怎么避免重复的 TTS 请求
高并发系统里,必须保证相同的 TTS 请求不会为同一段输入生成多个音频文件。这不仅浪费资源,还可能造成性能瓶颈。可以用 Redis 分布式锁来避免重复生成。
方案:Redis 分布式锁
在向外部服务(OpenAI、Google Cloud TTS 等)发起 TTS 请求之前,先用 Redis 分布式锁保证同一段文本只被处理一次。
结论
这篇文章讨论了怎么设计一个类似 Speechify 的 PDF 朗读系统。先定义功能范围,找出主要实体和接口,画出简单的高层架构图;再逐步满足功能和非功能需求,比如高扩展性和低延迟,把设计一层层改进。
为了把这套设计付诸实践,我从零做了 DocWiser,一个 Speechify 的替代品,支持导入 PDF、TXT、EPUB 等格式做朗读。它和 Speechify 一样提供免费试用,高级功能需要订阅。这个产品现在已经下线,但设计过程里的取舍仍然适用。