量化选股学习笔记(三):等权打败机器学习,纸面利润藏在微型股里
把 6 个因子合成一个分数:最简单的等权打败了 IC 加权、Ridge 和 OLS。再把分数变成组合做回测:纸面上每年多赚 3–10 个点,但大部分利润来自做空端和难以交易的微型股,而 5 年数据几乎证明不了什么。
这是我学习量化选股的第三篇笔记,也是阶段一的最后一篇。第一篇测了 40 个单因子,第二篇把它们放到行业内部重新检验。这一篇做两件事:把几个因子合成一个分数,再把分数变成真实的投资组合,看能赚多少钱。代码仍然由 Claude Code 编写,我负责提问、读代码和决定方向。
本文是学习记录,不构成任何投资建议。
这一篇要回答的两个问题
- 几个因子合在一起,能不能比最好的单因子更强?机器学习能帮多少?
- 前面一直在看“排名准不准”(Rank IC),但投资者关心的是:按这个排名买股票,能赚多少钱?
所有分析都沿用第二篇的做法:因子和收益都在行业内部排名,只研究“行业内选股”,不碰行业押注。
第一课:最简单的等权合成就赢了
第二篇最后留下 6 个核心因子,每个代表一个不同的故事:
| 因子 | 故事 | 行业中性 IC |
|---|---|---|
| 投入资本回报率 | 盈利 | +0.146 |
| 盈利收益率 | 盈利 + 估值 | +0.138 |
| 自由现金流率 | 现金流 | +0.126 |
| 股票发行(越少越好) | 融资 | +0.104 |
| Altman Z-score | 财务安全 | +0.102 |
| 股息率 | 分红 | +0.079 |
最简单的合成方法是等权:把 6 个因子的行业内排名直接取平均。它不从数据里学任何东西。
测试用的是 walk-forward:测 2015→2016 年时只能用 2014 年的数据学习,测 2016→2017 年时只能用 2014–2015 年,依此类推。对手是“到目前为止最好的单因子”,也就是每个测试年份之前 IC 最高的那个因子。如果直接拿测试年份里表现最好的因子来比,就是偷看未来。
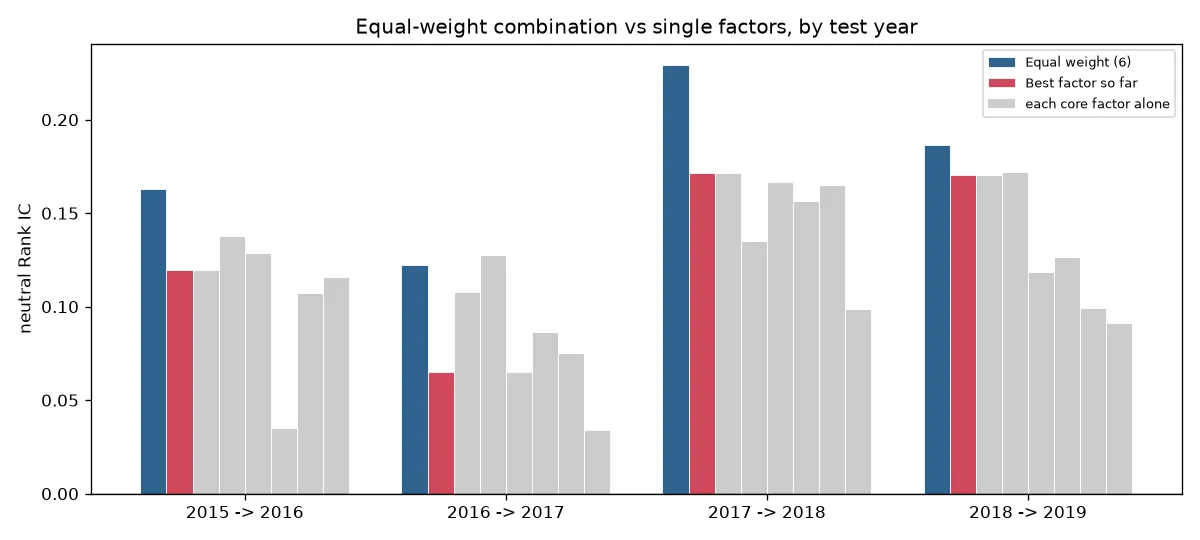
| 2015→16 | 2016→17 | 2017→18 | 2018→19 | 平均 | |
|---|---|---|---|---|---|
| 等权(6 个因子) | +0.163 | +0.122 | +0.229 | +0.186 | +0.175 |
| 到目前为止最好的单因子 | +0.119 | +0.065 | +0.171 | +0.170 | +0.132 |
等权 4 年全胜。更有意思的是,提升多少可以事先算出来。如果 k 个因子的 IC 都差不多,彼此的平均相关系数是 ρ,那么等权合成后的 IC 大约是:
合成 IC ≈ 单因子平均 IC × √( k ÷ (1 + (k − 1) × ρ) )
代入 6 个因子、平均相关 0.31:0.117 × 1.53 = 0.179,实际是 0.175,几乎一模一样。
- 如果 6 个因子完全不相关,IC 能放大 √6 ≈ 2.45 倍。
- 如果完全相关,6 个因子就等于 1 个。
这就是主动管理基本定律 IR ≈ IC × √breadth 里 breadth 的真实含义:算的是“不同的故事”有几个,而不是因子有几个。
还有一个细节:“到目前为止最好的单因子”在 2016→2017 年选了自由现金流率(它在 2014–2015 年表现最好),结果那一年正好是它最差的一年。等权从不依赖某一个因子,所以避开了这种“追逐过去赢家”的陷阱。
第二课:学得越多,结果越差
接下来让数据学权重,看能不能打败什么都不学的等权:
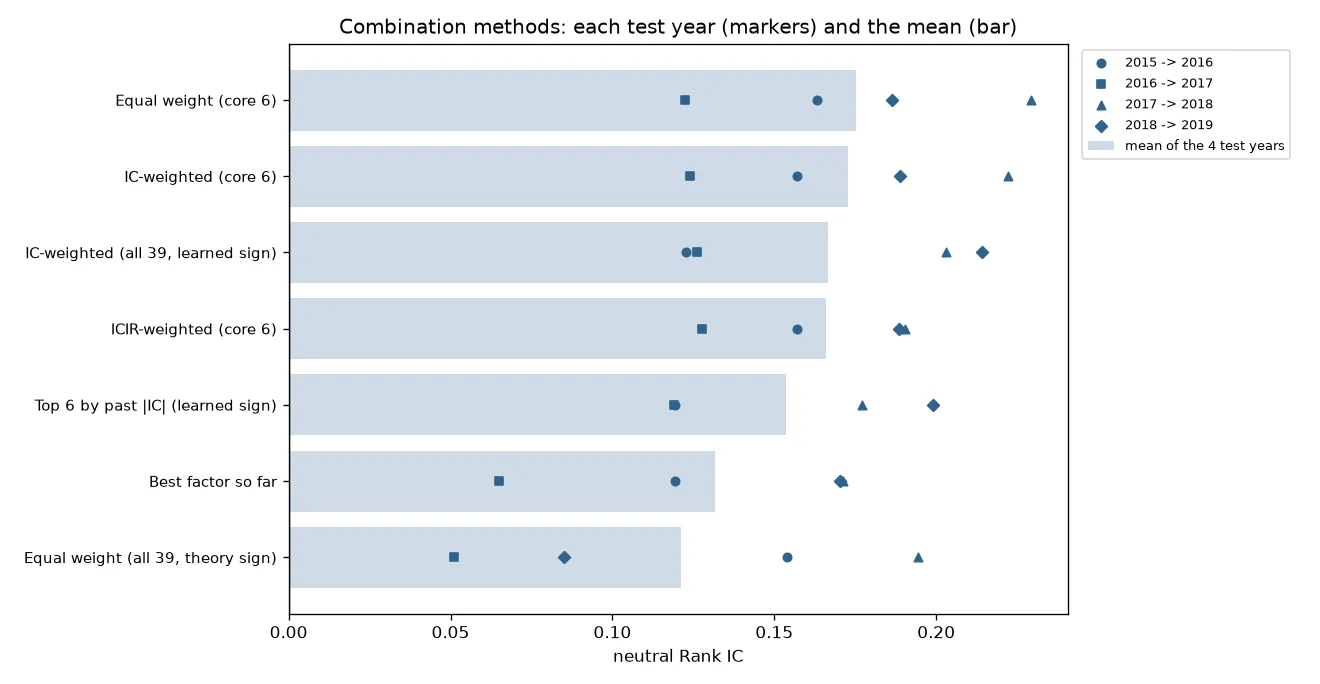
| 方法 | 学了什么 | 平均 IC |
|---|---|---|
| 等权(核心 6 个) | 什么都不学 | +0.175 |
| IC 加权(核心 6 个) | 用过去的 IC 当权重 | +0.173 |
| Ridge 回归(核心 6 个) | 权重 + 因子之间的相关性 | +0.172 |
| IC 加权(全部 39 个,方向也从过去学) | 不手选因子 | +0.166 |
| OLS 回归(核心 6 个) | 权重 + 相关性 | +0.165 |
| 过去 IC 最高的 6 个 | 让数据挑因子 | +0.154 |
| 全部 39 个,按理论方向等权 | 什么都扔进去 | +0.121 |
什么都不学的等权仍然是第一。 学界把这叫作“1/N 难题”(DeMiguel、Garlappi 和 Uppal,2009):数据很少时,估计权重产生的误差,比更好的权重能带来的好处还大。我们每次只有 1–4 年的训练数据。
几个细节值得展开:
- IC 加权和等权几乎一样(两者分数的相关系数 0.99)。6 个因子过去的 IC 都差不多,学出来的权重只在 0.08 到 0.24 之间,等权是 0.17。只有因子质量差别很大时,学权重才有意义。
- 让数据挑“IC 最高的 6 个”反而更差,尽管被挑中的每个因子单独看 IC 都更高。原因是它每年挑出来的几乎全是利润指标:投入资本回报率、ROA、ROE、经营利润率……同一个故事讲了 6 遍,breadth 几乎没有增加。
- 把 40 个因子全扔进去,结果最差。有 13 个因子的实际方向和理论相反(规模、营收增长等),还有很多只是噪音。
- “完全不手选”的 +0.166 是最诚实的数字。 那 6 个核心因子,是我在前两篇里看过全部 5 年数据(包括测试年份)后才选出来的,这本身有一点偷看未来。而全部 39 个因子、权重和方向都只从过去学的版本,没有用到任何测试年份的信息。两者只差 0.009,可以粗略看成“手选因子”占的便宜:不大。
Ridge 自己“退化”成了 IC 加权。 Ridge 每年都选正则化最强的那一档;我把搜索范围扩大到 1000 万,它仍然选最大的。原因是正则化足够强时,Ridge 的系数会和 X’y 完全成比例(相关系数 1.000),而 X’y 正是每个因子自己和收益的协方差,基本就是它的 IC。所以数据的结论是:在这里,“考虑因子之间的相关性”弊大于利。
OLS 为什么更差? 看它在 39 个因子上学出来的系数就明白了:杠杆 −0.073、负债/权益 +0.063,这两个因子的相关系数是 0.76,系数却一正一负,几乎互相抵消;权重最大的竟然是 EBITDA/EV(−0.078),方向和理论相反。OLS 在拟合几个几乎一样的因子之间的细小差别,而这些差别基本是噪音。这就是多重共线性加过拟合。
因为线性模型已经清楚地说明“学得越多越差”,我没有再测树模型(随机森林、梯度提升)。它们要学的东西更多,在只有几年年度数据时,预期结果是“不会更好”。树模型留到换成月度数据之后再测。
第三课:R² 只有 3%,也可以是很强的信号
OLS 在测试集上的 R² 是 2.90%,Ridge 只有 0.45%,但 Ridge 的 IC 更高。
- R² 看的是预测值的大小准不准。强正则化会把所有预测值都压向 0,所以 R² 很低。
- IC 只看顺序。选股交易靠的是顺序:买排名靠前的,卖排名靠后的。
还要注意 R² 有多小:只解释了 3% 的收益排名,IC 就已经是 0.17,这在选股里已经是很强的信号。所以在金融预测里,不能用“R² 只有 3%”来说明模型没用。
第四课:组合收益是平均数,平均数怕坏数据
现在把分数变成组合:每年在每个行业里按分数把公司分成 5 组(Q1 最差,Q5 最好),每组等权买入,持有一年,第二年重新分组。等权合成不需要训练,所以 5 年都能测。
前两篇用的都是中位数和排名,坏数据影响不了。但组合收益是平均数,问题马上就出来了:数据里有一行 GNL 的“下一年收益”是 +2,418,601%,就因为这一行,2014→2015 年整个市场的平均收益从 0% 变成了 +1,017%。
直接删掉收益超过 1000% 的行也不行。37 行里有真有假:
- 真的:Tandem Diabetes(TNDM)2018 年真的涨了约 14 倍,Axsome(AXSM)2019 年真的涨了约 36 倍。
- 假的:INVH、PEN、AKCA 那一年才上市,“年初价格”根本不存在。
没有一条线能把真假分开。所以我的做法是封顶:超过 1000% 的一律按 1000% 计算。真正的大赢家仍然算大赢家,错误数据也不会把平均数搞崩。
这个选择还会影响结论:37 行里有 13 行落在最差的一组,只有 4 行在最好的一组。删掉或压低这些极端值,等于删掉最差组里的大赢家,策略会显得更好。我比较了几种处理方式,封顶 1000% 是最保守的(最好一组跑赢市场 +3.4 个点;其他方式是 +4.1 到 +4.3)。
后面按市值加权时,又发现了另一个错误:IGLD(以色列的一家小电信公司)记录的市值是 96 万亿美元,比整个美股加起来还大,一家就占了 78% 的权重。等权计算时,这个错误一直藏着。每换一种方式使用某一列数据,都可能暴露出新的错误。
第五课:纸面上,最好的一组每年多赚 3.4 个点
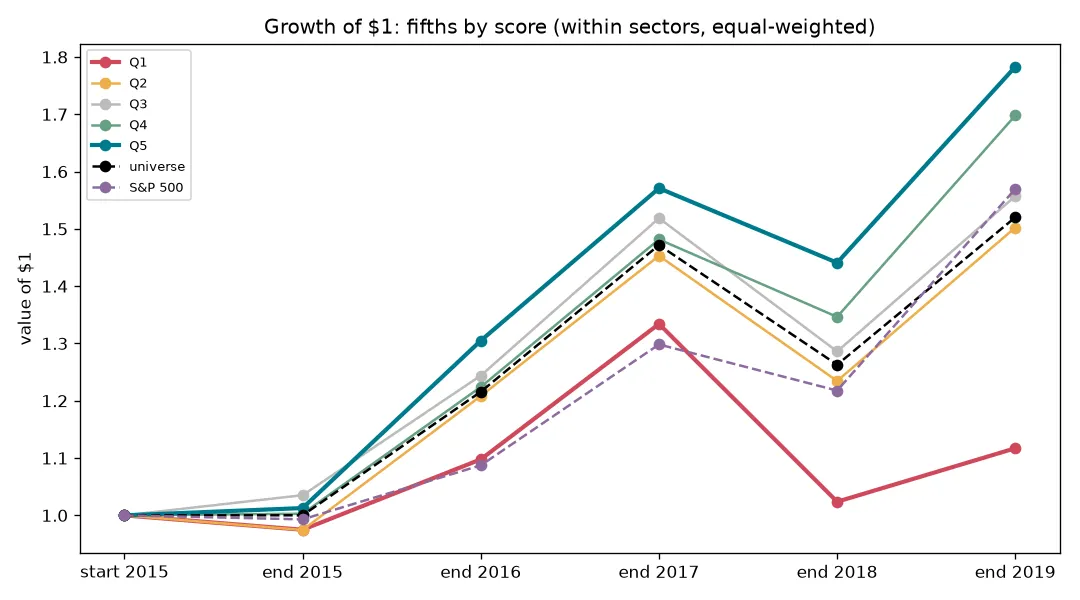
| Q1 最差 | Q2 | Q3 | Q4 | Q5 最好 | 等权市场 | 标普 500 | |
|---|---|---|---|---|---|---|---|
| 平均每年收益 | +3.5% | +9.7% | +10.3% | +12.1% | +13.2% | +9.8% | +10.2% |
| 1 美元 5 年后 | 1.12 | 1.50 | 1.56 | 1.70 | 1.78 | 1.52 | 1.57 |
- 5 组从低到高是一级一级往上的台阶。
- 最好的一组每年比等权市场多赚 3.4 个点,5 年里有 4 年跑赢。
- 和标普 500 比没那么亮眼,5 年里只有 3 年跑赢。我们的组合是每组 800 只左右、以小公司为主的等权组合,标普 500 是大公司指数,比较的对象本来就不一样。
第六课:最差的一组像一堆彩票
| Q1 最差 | Q5 最好 | |
|---|---|---|
| 组合平均收益 | +3.5% | +13.2% |
| 中位数股票的收益 | −8.2% | +10.8% |
| 一年内涨超过一倍的股票比例 | 6.1% | 1.9% |
最差的一组里,大多数股票在亏钱,但少数几只暴涨,把平均数拉了上去。只占 Q1 约 1% 的 10 只最好的股票,平均给 Q1 的收益加了 7.6 个点。
这带来一个奇怪的现象:2016→2017 年按排名看,打分是有效的(P4 那一年的 IC 是 +0.122;中位数股票 Q1 +3.2%,Q5 +17.8%),但按平均收益算,最差组和最好组几乎一样。当收益分布这么不对称时,排名准和赚钱多不一定是一回事。 学界也有相关研究:Bali、Cakici 和 Whitelaw(2011)发现,投资者会为这种“彩票型”股票付出过高的价格。
第七课:多空,2/3 的钱来自做空
多空就是买最好的一组,同时做空最差的一组(借来股票先卖,跌了再买回来还)。大盘整体的涨跌大致抵消,剩下的就是选股能力。它可以拆成两条腿:
多空收益 =(Q5 − 市场)+(市场 − Q1)
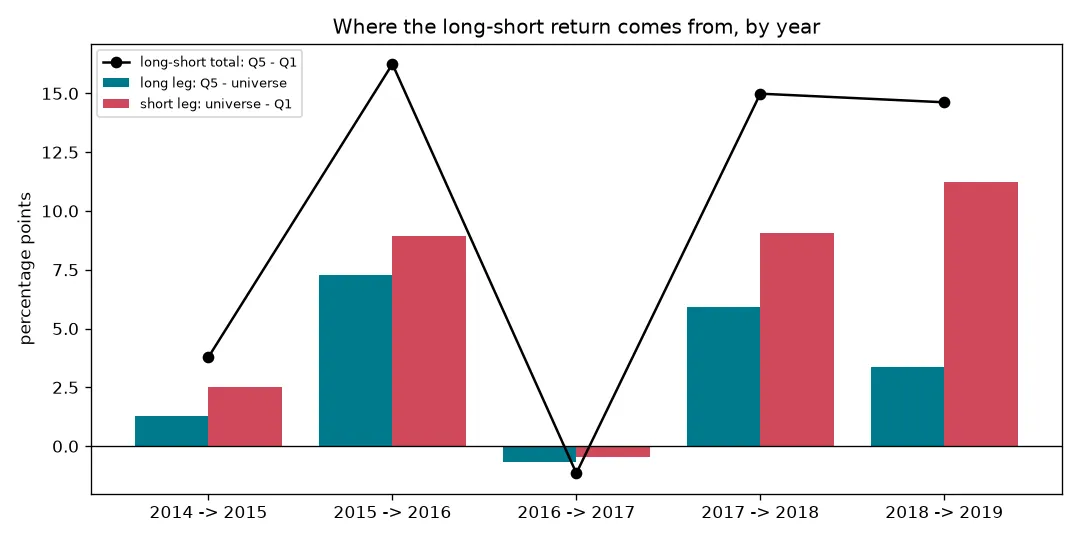
| 平均年收益 | 波动 | 最差的一年 | |
|---|---|---|---|
| 多头腿(Q5 − 市场) | +3.4 | 3.3 | −0.7 |
| 空头腿(市场 − Q1) | +6.3 | 5.0 | −0.5 |
| 多空合计 | +9.7 | 7.9 | −1.1 |
| 等权市场 | +9.8 | 16.2 | −14.2 |
- 2/3 的收益来自做空差公司。 这和前两篇用中位数看到的一致:信号最擅长的是找出输家。这也和 Stambaugh、Yu 和 Yuan(2012)的发现一致:很多异象的利润主要集中在空头一侧。
- 大跌年反而赚钱。 2017→2018 年市场跌了 14.2%,多空赚了 15.0%:市场下跌时,差公司跌得最惨。
- 但空头腿是在“彩票”上做空。 做空的人从几百只下跌的股票上一点一点赚钱,又被那 10 只暴涨股一口吐回去一大半。
第八课:加上现实,利润大多在微型股里
交易成本影响很小。 一年只调仓一次,最好的一组每年换掉约 40% 的股票。按公司大小收取交易成本(大公司每笔 0.05%,微型股 1.5%)后,多空从 +9.7 降到 +8.3。
借券费影响很大。 做空要借股票、付利息。加上每年 5% 的借券费,多空只剩 +3.3。而最差那组又小又投机的股票,恰恰最难借、最贵。
最大的意外:去掉小公司,利润就消失了。
| 只保留市值 ≥ | 每年股票数 | 多空 | 赚钱年数 |
|---|---|---|---|
| 不限 | 3,949 | +9.7 | 4/5 |
| 3 亿美元 | 2,610 | +3.1 | 4/5 |
| 10 亿美元 | 1,837 | −1.1 | 2/5 |
最差的一组里 61% 是市值不到 3 亿美元的微型股。在大公司里,排名其实仍然有一点用(IC +0.076,中位数股票从最差组 +4.4% 一级级升到最好组 +10.7%),但太弱了,在平均收益里体现不出来。按市值加权后,最好的一组只比市场多赚 0.2 个点。
这一点很重要,因为微型股恰恰是交易成本最高、最难做空、能放进去的钱最少的股票。一个基金不可能往一家市值 8000 万美元的公司里投很多钱。学界也有类似的发现:Fama 和 French(2008)发现不少异象主要集中在微型股里,在大公司中弱得多甚至消失;Hou、Xue 和 Zhang(2020)复现几百个异象时,控制住微型股的影响后,大部分都不显著了。
第九课:5 个数字能证明什么
| 收益/波动比 | 95% 可信区间 | 均值检验的 p 值 | |
|---|---|---|---|
| 多空 | 1.23 | 0.07 到 2.40 | 0.051 |
| 多头腿 | 1.05 | −0.04 到 2.14 | 0.078 |
| 只买最好一组 | 0.83 | −0.19 到 1.85 | 0.137 |
(可信区间用的是 Lo(2002)给出的夏普比率标准误。)
多空的 1.23 看起来不错,但真实水平可能低到接近 0,也可能高达 2.4。只有 5 年数据,就像只抛了 5 次硬币。
这里我要修正自己之前的一个说法。我原以为换成月度数据就能解决这个问题,但算一下就知道不行:
| 真实夏普比率 | 用年度数据,需要多少年才能确认它不是 0 | 用月度数据 |
|---|---|---|
| 0.5 | 17 年 | 仍然要 15 年 |
| 1.0 | 6 年 | 4 年 |
判断一个策略需要的是更长的年数,而不是更高的频率。 月度数据的好处在别处:每年 12 次机会检验排名、时间能对得上、可以做价格类因子。
另外两个问题,在这份数据里无法解决:
- 时间错位:收益从 1 月 1 日开始算,但年报要到 2–3 月才发布。每年持有期的前 2–3 个月,用的是当时还没人知道的信息,所以所有收益都被高估了一部分。
- 幸存者偏差:这份数据没有一行缺少下一年收益,只有 0.4–0.6% 的公司在下一年的文件里消失,远低于美股正常的退市率,而且股票池逐年变大(3,616 → 4,138)。数据很可能是事后用“整理时还存在的公司”拼起来的。消失的公司大多是失败者,也就是我们的 Q1,所以空头腿可能被低估了,而市场和最好一组的收益可能被高估了。
踩过的坑
- NaN 会让一切消失:动量和 F-score 没有 2014 年的数据,学出来的权重是 NaN。一个 NaN 权重就让整年的合成分数全部变成 NaN。没有历史的因子,权重应该是 0。
- 搜索范围的边界:Ridge 一直选网格里的最大值。最优值落在网格边缘时,要扩大范围再试一次。这次的结论是“越大越好”,背后有清楚的原因。
- 比较要用同一把尺子:每种方法都在同样的测试年份、同样的公司上比较,对手“最好的单因子”也只能用过去的数据来选。
- 删除极端值不是中性的操作:它会系统性地删掉最差组里的大赢家,让策略看起来更好。
- 数据错误藏在没用过的角度里:96 万亿美元的市值,只有按市值加权时才会暴露。
- 我的预测也有错:我预测“去掉微型股后收益会缩水但不会消失”,实际在 10 亿美元以上就消失了。我还错把“月度数据”当成判断夏普比率的解药。
阶段一总结
| 问题 | 答案 |
|---|---|
| 一开始那个 AUC 0.76 可信吗? | 不太可信,主要是测在了最容易的一年 |
| 应该预测什么? | 预测“谁比谁好”,不预测“涨不涨” |
| 哪些因子有效? | 几乎都在讲同一个故事:避开亏损公司 |
| 是选股能力还是行业押注? | 大约 3/4 是真实的选股能力 |
| 机器学习能帮多少? | 数据只有 5 年时帮不上忙,最简单的等权最好 |
| 能赚钱吗? | 纸面上能,但大部分利润来自做空端和微型股,而且每个数字的误差都很大 |
一句话:排名是真的,但纸面利润主要在最难交易的地方。
下一步
阶段二要换掉这份 Kaggle 数据,用 FMP 的 API 重新搭一个数据集,一次解决阶段一暴露的问题:
- 使用每份财报的真实发布日期,发布之后才使用;
- 包含已经退市的公司;
- 拉几十年的历史,而不是 5 年;
- 按月调仓和计算收益。
到那时,树模型、价格类因子和更严格的 walk-forward 才有足够的数据来公平地检验。