量化选股学习笔记(七):十种模型,一个答案
在月度数据上把多因子合成和机器学习完整做了一遍:IC 加权、OLS、Ridge、Lasso、LightGBM 和 PyTorch 神经网络,统一用 walk-forward 和两两对比来评。所有学过的模型都落在同一个 IC 上;最终回测的利润全部来自微型股,只做多、只买大公司的版本跑输了“全买”。
这是我学习量化选股的第七篇笔记。上一篇在月度数据上重做了单因子研究,得到了一张 18 个因子的成绩单。这一篇终于轮到机器学习:把这些因子合成一个分数,比较各种方法谁更好,最后做回测。代码仍然由 Claude Code 编写,我负责提问、读代码和决定方向。
本文是学习记录,不构成任何投资建议。
2026-10-23 更新:做到第九篇时发现市值数据有一个错误(见第四篇第七课的最后),修正后重跑了全部结果,本文的数字和图已经更新。所有模型的 IC 从约 0.116 降到约 0.097,回测收益也低了很多,主要因为样本里少了约 1.2 万个真实股价低于 1 美元的公司-月,它们 93% 在亏损,下个月收益的中位数是 −8.2%(其余股票是 −0.2%),几乎全落在最差的一组里,既容易预测,又是做空最赚钱的一批。结论没有变:模型不重要,利润来自微型股,大公司里几乎没有选股能力。
前面八步,为什么都没有机器学习
开始之前我问了一个问题:前面做了这么多,好像一直在处理数据,没用到什么机器学习?
其实前面做的都是机器学习流程里“建模之前”的步骤:
| 前面做过的 | 机器学习里的叫法 |
|---|---|
| 随机划分 vs 按时间划分(第一篇) | 模型评估、数据泄漏 |
| 构建 40 个因子 | 特征工程 |
| 行业中性化、去极值(第二篇) | 特征预处理 |
| 财报公布之后才能用(第四篇) | 防止标签泄漏 |
| 单因子成绩单(第六篇) | 基准 |
前面所有步骤,都是在准备干净的特征 X 和标签 y。数据有问题时,模型越强,学到的错误越多。
第一课:擂台规则
所有模型遵守同样的规则:
- 特征 X:18 个因子,每个都转成同月、同行业内的排名,范围是 −0.5 到 +0.5。
- 标签 y:下个月收益在行业内的排名。用排名而不是收益本身,是为了不让某只股票一个月暴涨 900% 主导训练。
- walk-forward:站在每个月底,只用当时已经知道标签的月份训练,给所有股票打分,再用下个月的真实收益检验。测试期是 2023 年 1 月到 2026 年 8 月,共 44 个月。
- purge:t 月的特征虽然已经知道了,但它的标签(t+1 月的收益)正是要预测的东西,所以必须从训练集里删掉。
评价模型主要看月度 IC(打分和下个月收益的排名相关系数)。比较两个模型时,用的是两两对比:每个月都用同一批股票,算两个模型的 IC 差值,再对这个差值算 t 值。某个月所有因子一起失效时,两个模型会同时变差,这部分噪声在差值里抵消掉了,小而稳定的差距就能显现出来。
不比 Sharpe 是因为 44 个月的 Sharpe 标准误大约是 0.5,0.1 的差距根本分辨不出来。
第二课:看了结果再挑因子,不会更好
先跑几个不用机器学习的基准:
| 方法 | IC | t |
|---|---|---|
| 阶段一选定的 6 个因子,等权 | 0.087 | 6.6 |
| 全部 18 个,等权 | 0.085 | 5.4 |
| IC 加权(每月只用过去的数据学权重) | 0.097 | 6.1 |
| [偷看] 上一篇成绩单里最好的 7 个,等权 | 0.091 | 6.2 |
| [偷看] 只用低波动 | 0.091 | 4.6 |
“偷看”指的是:上一篇的成绩单用的是 2021–2026 年的数据,已经包含了这里的测试期。按它挑出来的因子,还不如每个月只用过去数据老老实实学出来的权重。看了结果再挑因子,看起来像本事,其实不是。
另一个发现:合成之后几乎没比单个因子好。只用低波动一个因子,IC 就有 0.091。这些因子讲的故事大量重叠,而且都在对同一批股票投反对票:波动大、亏损的小公司。
第三课:线性模型,权重不同,排序相同
OLS、Ridge、Lasso 三种线性模型,IC 分别是 0.096、0.097、0.095,和 IC 加权的两两对比 |t| 只有 0.1 到 0.4,完全没有差别。Ridge 每个月选的正则化强度在 0.0001 到 100 之间来回跳,说明选哪个都一样。
但它们学到的权重差别很大,这里有两个有意思的地方:
- 盈利类因子互相重复。单独看,五个盈利指标都不错;放进回归里,权重主要给了自由现金流率、盈利收益率和投入资本回报率;ROA、“是否盈利”、毛利率和股息率的权重接近 0,后三个 Lasso 在 80–90% 的月份直接删掉了。
- 价值因子回来了。账面市值比单独的 IC ≈ 0,在回归里却是权重最大的几个之一。我用数据核实了原因:便宜的股票往往盈利差、波动大(和盈利类因子的相关约 −0.2)。把盈利和波动固定住之后,便宜的股票确实跑赢贵的。这和 Asness、Frazzini、Pedersen(2019)的结论一致:价值和质量放在一起用,效果更好。
权重差别这么大,预测却几乎一样,原因是特征之间高度相关时,有很多组不同的权重都能给出几乎相同的排序。这叫“平坦最优”(Dawes 1979),也是第三篇里“等权打败机器学习”的原因。
第四课:随机交叉验证会虚高 16%
第一篇学过,时间序列数据不能随机划分。这次把代价算了出来,同一个 LightGBM、同样的测试月份:
| 验证方式 | IC | IC 为正的月份 |
|---|---|---|
| 随机抽行,5 折交叉验证 | 0.114 | 80% |
| 按整月随机分组,5 折交叉验证 | 0.093 | 80% |
| walk-forward | 0.095 | 73% |
随机抽行,成绩虚高 20%。有意思的是,泄漏来自同一个月的其他股票,而不是“用未来预测过去”:按整月分组时,模型同样会用未来的月份训练,IC 却和诚实的做法几乎一样。原因是每个月都有自己的共同冲击(比如 2021 年 1 月垃圾股集体暴涨),随机抽行时同一个月 80% 的股票进了训练集,树模型能从特征的组合方式里认出是哪个月,就学会了那个月谁涨。
第五课:LightGBM 和神经网络,也落在同一个地方
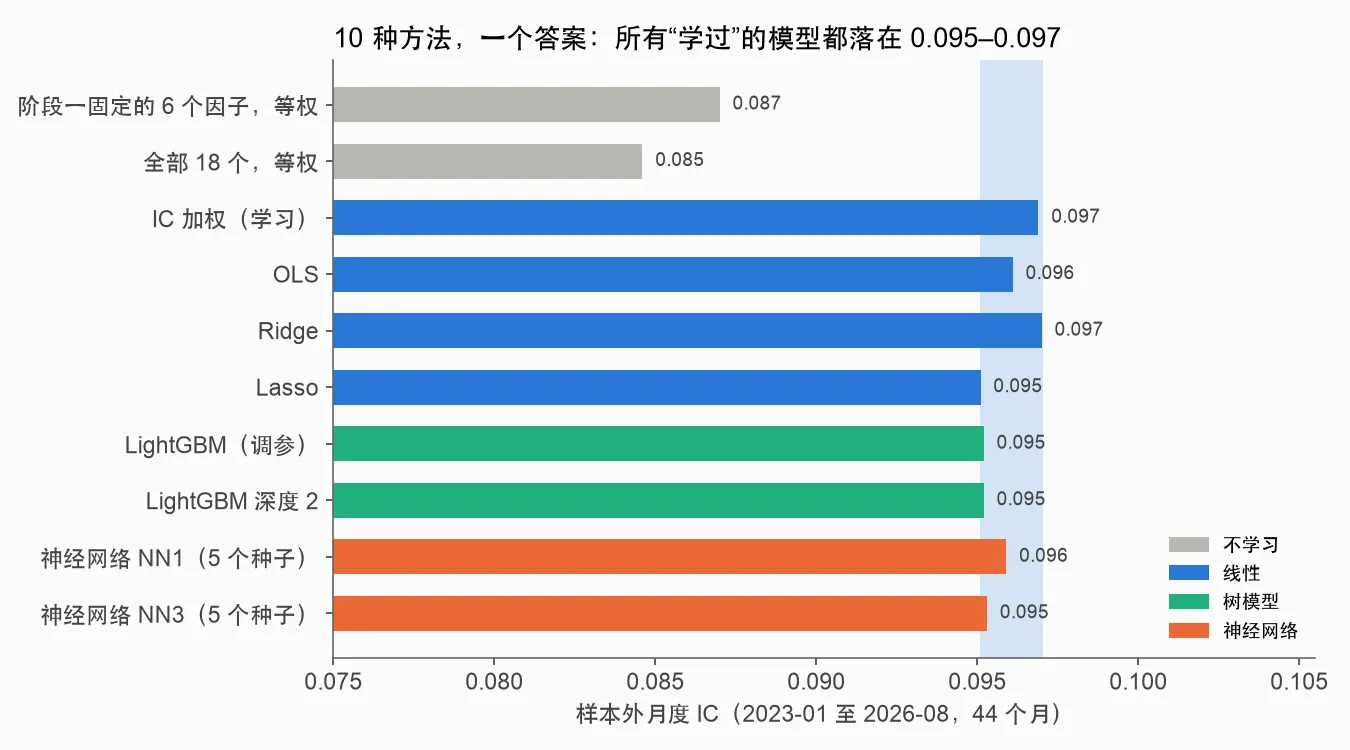
LightGBM(梯度提升树):早停只留下 20 到 100 棵小树,再多验证集就不再改善。深度 1 的树(只能画各特征各自的曲线,没有交互作用)和深度 4 的树(可以组合 4 个特征)IC 一样。
神经网络(用 PyTorch 写的 3 层小网络,参照 Gu、Kelly 和 Xiu 2020 年论文里表现最好的结构):
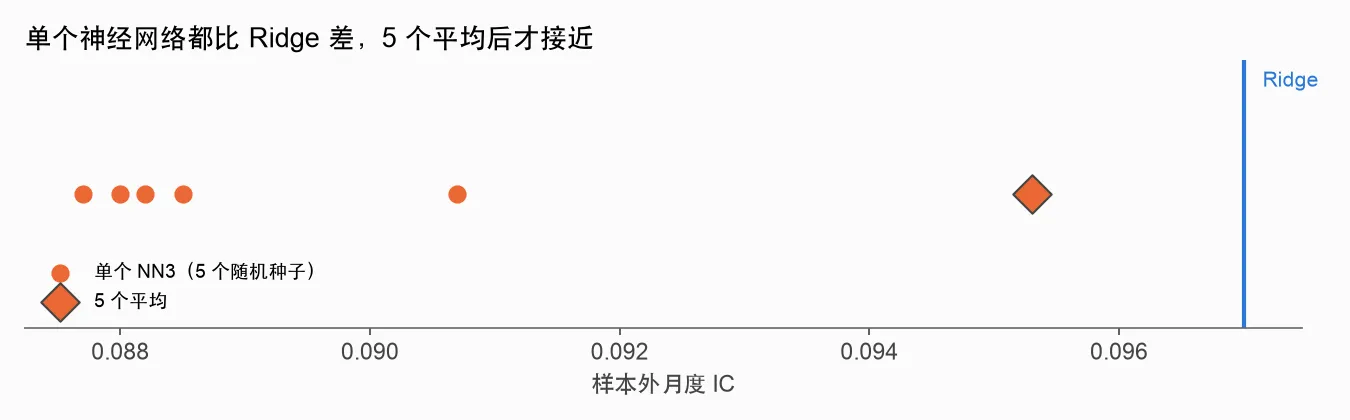
- 单独一个网络,5 个随机种子全都比 Ridge 差。两个种子给出的打分相关性只有 0.69:每个网络都学到了同样的信号,再加上各自不同的噪声。
- 5 个平均之后才接近 Ridge(0.095 vs 0.097,差别不显著)。而 Ridge 根本不需要随机种子。
- 1 层的网络不比 3 层差,深度没有帮助。
修正市值之前,神经网络比调过参的 LightGBM 好 0.004,t = 2.2,看起来“显著”。但这一步一共做了大约 20 次两两对比,按 5% 的概率,碰巧出现一两个 |t| > 2 完全在预期之内(Harvey、Liu 和 Zhu,2016)。修正之后,这个差距就消失了(+0.001,t 0.4)。
所有学过的模型,IC 都在 0.095 到 0.097 之间。18 个特征、68 个月的数据里大概就有这么多信号,任何合理的加权方式都能找到它,更复杂的模型也找不到更多。
第六课:模型确实学到了东西,只是没用
既然结果一样,树和神经网络到底学到了什么?用置换重要性、部分依赖和交互作用打开看了一下。
数据里确实有交互作用,而且很大:
| 交互作用 | 数据里 |
|---|---|
| 动量 × 规模 | 动量在小公司 IC 0.085,大公司只有 0.035 |
| 低波动 × 是否盈利 | 低波动在亏损公司 IC 0.147,盈利公司只有 0.023 |
| 动量 × 波动 | 在波动大的股票里更有效(0.074 vs 0.054) |
LightGBM 和神经网络都找到了这三个交互作用,方向全对,线性模型做不到。那为什么 IC 没有提高?
因为各模型对股票的排序几乎一样,相关性在 0.85 到 0.98 之间。非线性和交互作用只调整了排序里大约 10% 的部分,而一个月的收益噪声很大,这些调整在有的月份有帮助、有的月份有害,平均下来抵消了。
还有一个现象:三个模型最依赖的特征各不相同,排序却几乎一样。Breiman(2001)把这叫“罗生门效应”:很多模型都能同样好地拟合数据,但各自的“解释”不同。所以不要过度解读某一个模型的特征重要性。
第七课:回测,利润全部来自微型股
既然模型之间没有差别,就选最简单的:IC 加权,没有超参数,每个权重都看得懂,换手也最低。先选定模型,再做回测,不能把所有组合都试一遍再挑最好的。
这次的回测更接近真实交易:每只股票有自己的权重,持有期间会随涨跌漂移;调仓时按实际要交易的量、按每只股票的市值收取交易成本;做空每年付 2% 借券费。
季度调仓比每月调仓好得多:成本从每月 0.80% 降到 0.47%,扣成本后的多空收益从每月 +0.12% 升到 +0.74%(年化约 +7%)。上一篇发现信号衰减很慢,每月调仓主要是在付交易成本。不过调仓时点有运气成分:同样是季度调仓,从 1 月、2 月、3 月开始,结果分别是 +0.74%、+0.64%、+0.38%。(修正市值之前是 +1.71% 左右:被错误放进来的 1 美元以下仙股,正是做空最赚钱的那批。)
然后是最重要的一张图:
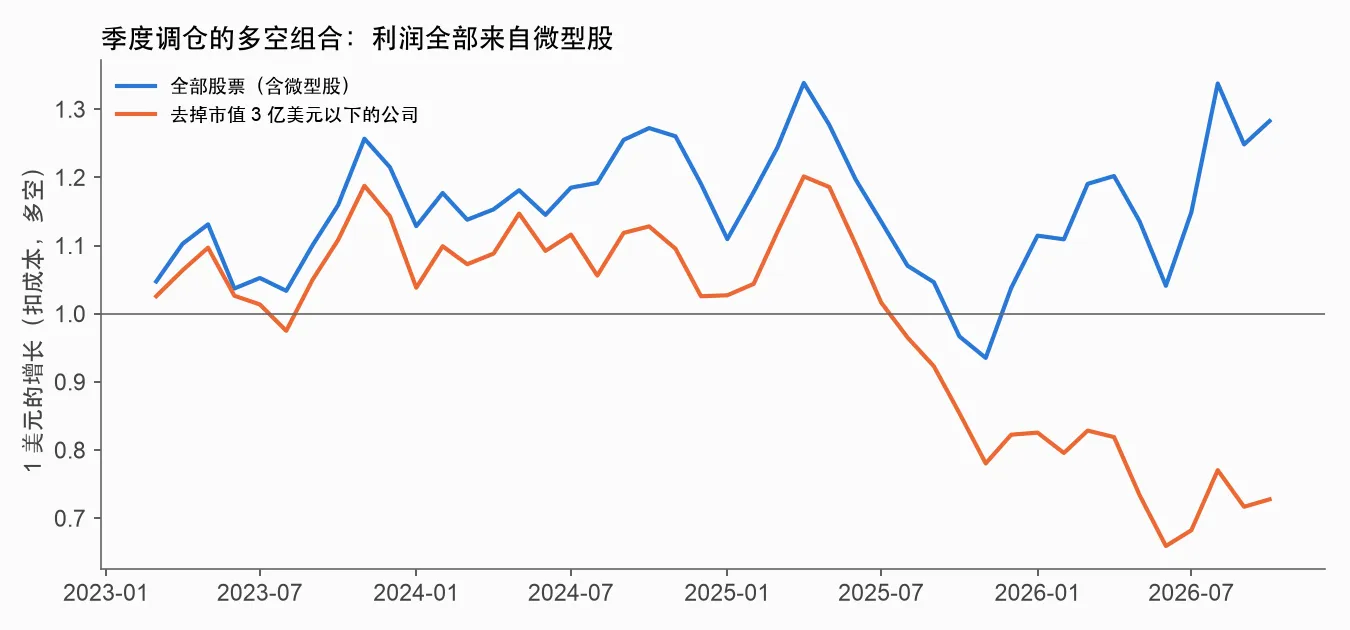
去掉市值 3 亿美元以下的公司后,多空收益在所有版本里都是负的,连扣成本之前都是负的。利润全部来自做空小型、亏损、波动大的股票,而这些股票在现实中往往借不到,借券费也远高于 2%。第三篇在 Kaggle 数据上发现过同样的现象,这次在样本外、真实数据上又验证了一次。Hou、Xue 和 Zhang(2020)复现了几百个异象,结论也一样:很多异象主要来自微型股。
再用 Fama-French 五因子加动量做回归,看看还剩多少超额收益:
| 版本 | alpha(每月) | t | R² |
|---|---|---|---|
| 多空,全部股票 | +1.16% | 1.2 | 0.56 |
| 多空,去掉微型股 | −0.11% | −0.2 | 0.77 |
| 只做多,按市值加权 | −0.13% | −1.5 | 0.97 |
去掉微型股后,这个策略就是已知因子的组合:做多赚钱的公司、偏大公司、偏低风险。只做多的版本 R² 是 0.97,基本就是市场本身。全部股票版本的 alpha 有 1.2%,但 t 只有 1.2,Sharpe 0.43 的 95% 区间是 −0.62 到 +1.48,44 个月连 0 都排除不了。
第八课:只做多、只买大公司
看完上面的结果,我想知道:如果只做多,而且只买大公司呢?于是又跑了一个版本:只买市值 10 亿美元以上的公司,每个行业取分数最高的 20%(约 390 只)。
需要说明的是,这是看过结果之后才提出的新问题,在同样的 44 个月上又测了一次,严格来说只能算探索。
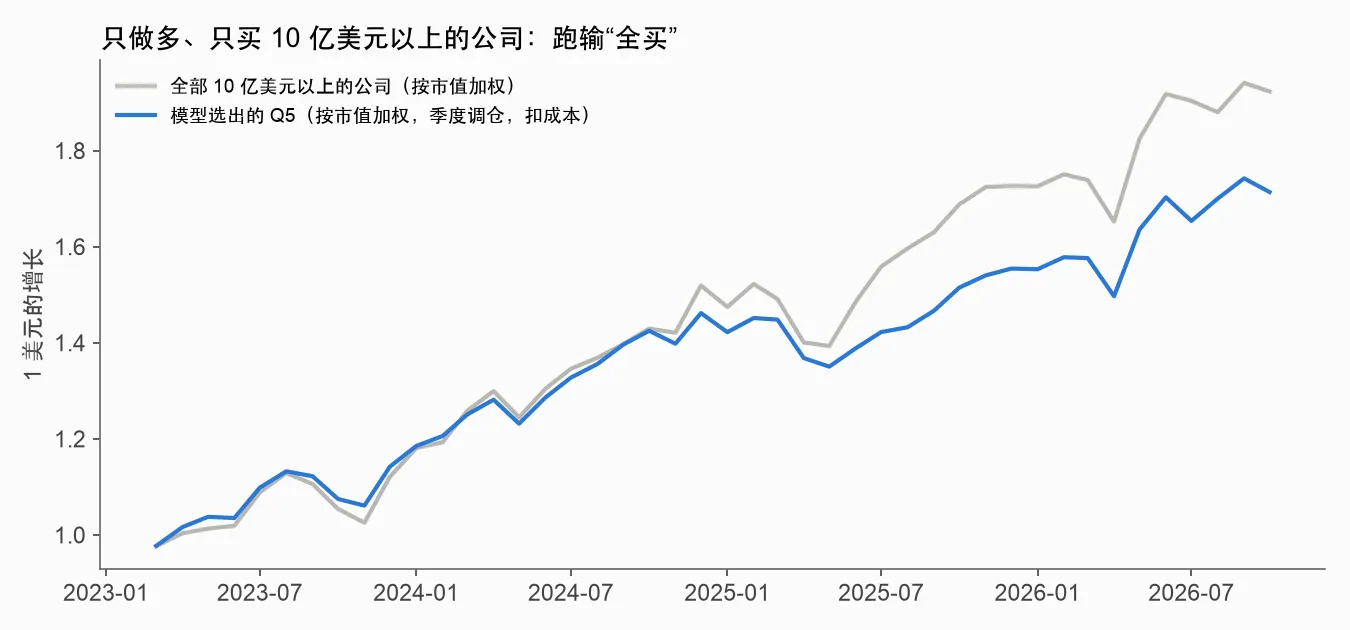
| 只做多,10 亿美元以上 | Q5 年化 | 全买年化 |
|---|---|---|
| 等权,季度调仓 | +10.2% | +11.6% |
| 按市值加权,季度调仓 | +15.8% | +19.5% |
同期整个美股市场年化 +20.7%。两种门槛(10 亿、100 亿美元)× 两种加权方式 × 两种调仓频率 × 两种权重学法(全部股票学的、只用大公司学的),一共 16 个版本,全部跑输“全买”。
原因有两个:
- 因子在大公司里弱得多。合成分数的 IC,全部股票是 0.097,10 亿美元以上只有 0.03,100 亿美元以上几乎是 0,没有预测力。
- 这几年是最大的公司领涨。同样买 10 亿以上的全部公司,按市值加权年化 +19.5%,等权只有 +11.6%。而模型偏好稳定、便宜、赚钱的公司,正好避开了领涨的那批大型成长股。从图上看,2025 年以前 Q5 和“全买”基本同步,差距主要出现在 2025 年之后。
一个工程上的坑
第一次运行“打开模型”的脚本时,程序卡了 10 分钟,CPU 占用是 0%。查下来发现:LightGBM 和 PyTorch 在同一个进程里不能同时用。两个库各自带了一份多线程运行库(OpenMP),在 Mac 上互相冲突。先导入 LightGBM,PyTorch 一运算就崩溃;PyTorch 启动线程之后,LightGBM 一训练也会崩溃。最后的解决办法是每个模型在自己的子进程里运行。模型本身没问题,问题出在运行环境上,这类问题在真实项目里很常见。
和学界的对照
- Gu、Kelly 和 Xiu(2020)发现树模型和神经网络比线性模型好,但他们有 94 个公司特征(再加上交互项)、3 万只股票、60 年数据。我们只有 18 个特征、68 个月,更灵活的模型找不到线性模型漏掉的东西。
- 平坦最优(Dawes 1979):特征相关时,“粗糙”的线性权重和最优权重几乎一样好。
- 罗生门效应(Breiman 2001):同样好的模型,可以有完全不同的解释。
- 微型股(Hou、Xue 和 Zhang 2020):很多异象主要来自微型股,这次的利润也全部来自微型股。
- 多重检验(Harvey、Liu 和 Zhu 2016):做了很多次检验时,t > 2 的门槛不够。
踩过的坑
- 我的解释有一半是错的。我先写了“便宜的股票往往盈利差、波动大,所以单独看价值因子无效”,然后用数据检查:对账面市值比成立,对市销率不成立(它和盈利类因子几乎不相关)。解释要用数据核实,不能只靠推理。
- 不同模型的预测值单位不同。Ridge 选了很大的正则化强度,预测值整体被压缩得非常小,但排序没变。直接比较预测值,Ridge 看起来什么都没学到。要先换算成同一个单位。
- 不要给模型看不存在的数据。一开始为了看交互作用,我把“是否盈利”这种只有两个取值的特征设成了 ±0.4,真实数据里根本没有这样的公司。后来改成按真实值分组。
- 只看一段 13 个月的数据会得出错误的结论。在最后 13 个月里,LightGBM(0.113)和神经网络(0.110)都比 Ridge(0.100)好;但在 44 个月里,它们并没有更好。
结论和下一步
- 信号是真的:样本外 IC 约 0.10,t 约 6。
- 模型不重要:10 种方法得到同一个答案。真正有影响的是“要不要从数据学”,以及交易成本,比如季度调仓。
- 能实际交易的部分就是已知因子:去掉微型股后没有超额收益,在大公司里几乎没有选股能力。
要在大公司里获得超额收益,需要新的、和现有因子不相关的信息,比如分析师预期修正、盈余公告后漂移、另类数据,而不是在这 18 个因子上换更复杂的模型。按两个信号合成的公式估算,一个和现有分数完全不相关、单独 IC 只有 0.10 的新信号,就能把合成后的 IC 从 0.097 提到 0.14 左右(√(0.097² + 0.10²) ≈ 0.139),比任何模型升级都有用。
下一步有两个方向:一是加入新的信号;二是做模拟盘,每个月月底按规则生成组合并记录下来,下个月用真实收益检验。这是真正的样本外检验,因为做决定的时候,结果还没有发生。