量化选股学习笔记(四):重建数据集,把“偷看未来”和“幸存者偏差”一点点去掉
用 FMP 的 API 重新搭一张每月一行的股票数据表:财报公布后才能用、死掉的公司也要在、一家公司只算一次。过程中发现数据源本身缺少 2020 年以前的死公司,于是把研究期改成 2021–2026。最后在新数据上做了第一次样本外检验。
这是我学习量化选股的第四篇笔记。前三篇(一、二、三)用的都是 Kaggle 上的 5 年年度数据。这一篇不讲因子,只讲一件事:把数据做对。代码仍然由 Claude Code 编写,我负责提问、读代码和决定方向。
本文是学习记录,不构成任何投资建议。
2026-10-23 更新:做到第九篇时,发现这张表里有一个影响很广的错误:一些反复合股的小公司,市值被放大了几十到几万倍,股价过滤也用错了价格。修正后重跑了全部结果,本文的数字和图已经更新,错误本身写在第七课的最后。
阶段一留下的三个问题
第三篇最后列出了 Kaggle 数据的三个硬伤:
- 偷看未来:收益从 1 月 1 日开始算,但年报要到 2–3 月才发布。
- 幸存者偏差:这份数据只有 0.4–0.6% 的公司会在下一年消失,远低于正常的退市率。中途破产、退市的公司大多不在里面。
- 只有 5 年:5 个年收益几乎证明不了任何事。
这一阶段的目标是用 FMP(Financial Modeling Prep)的付费 API,自己搭一张没有这些问题的表:每家公司每个月一行,每一行只包含那一天已经公开的信息。
第一课:数据源有限额,先算账再下载
我的 FMP 套餐有两个限额,而且都和一个正在运行的线上业务共用:
| 限额 | 线上业务已经用掉 | 我的做法 |
|---|---|---|
| 每分钟 300 次请求 | 不固定 | 平时最多用 150 次;线上业务暂停的那个晚上用 250 次 |
| 每 30 天 20 GB 流量 | 约 7 GB | 这个项目最多用 10 GB,到上限自动停止 |
先实测了一下传输量:一家有 22 年历史的大公司,日线价格不压缩时约 950 KB,开启 gzip 压缩后只有约 120 KB,小了大约 8 倍。最初的代码没开压缩,如果直接下载,流量就会超标。
所有请求都经过同一个函数,它负责四件事:
- 限速:多线程下载时排队领号,号与号之间间隔固定时间。
- 流量记账:记下压缩前和压缩后的字节数,累计到一个文件里,所以跨多次运行也不会漏算。
- 本地缓存:每个请求的答案都存成一个文件,再问同一个问题时直接读文件。下载中断后重启,会从停下的地方继续。
- 保护密钥:API key 只从本地的
.env读取,日志和错误信息里打印的都是不带 key 的版本。
隔夜下载一共发了 66,342 次请求,0 个错误,加上之后的补充下载,总流量是压缩后 0.72 GB、压缩前 6.4 GB。
第二课:最大的发现,死掉的公司去哪了?
原计划是研究 2004–2026 年。把价格变成月度数据后,我算了每年有多少公司退市:
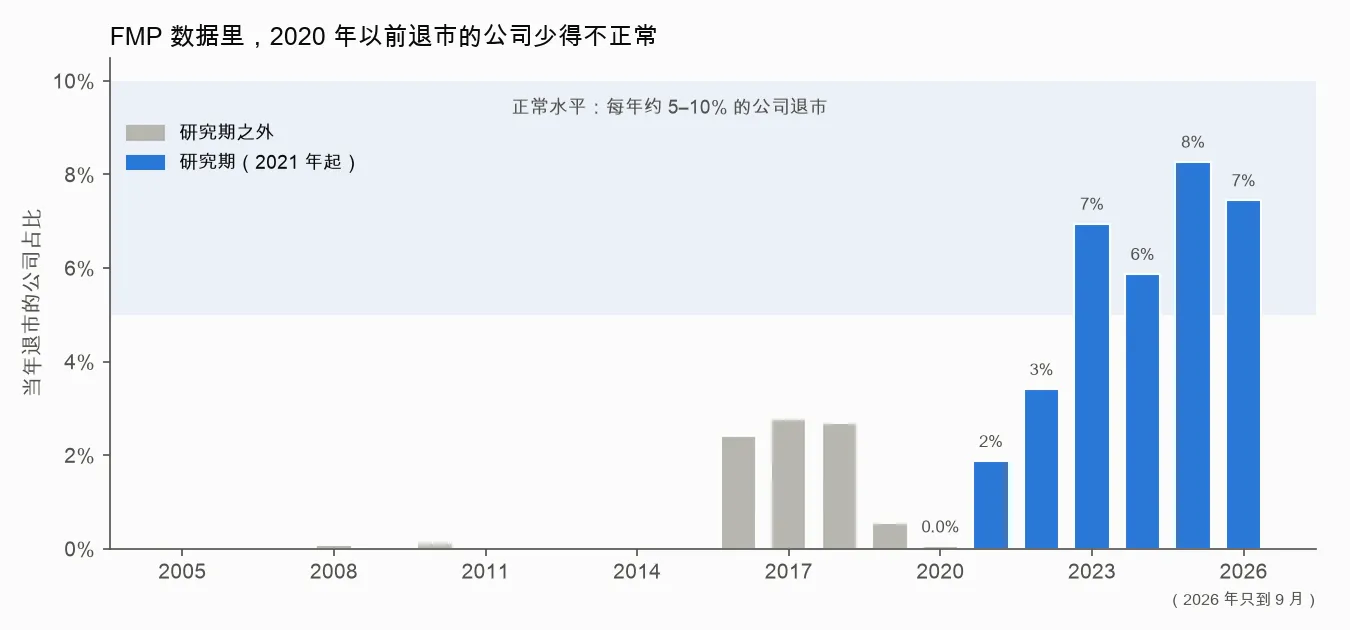
正常情况下,美股每年大约有 5–10% 的上市公司因为被收购、破产或不达标而退市。而在 FMP 的数据里,2004–2015 年几乎是 0%,2016–2018 年也只有 2–3%,2019–2020 年又接近 0。 2021–2022 年回升到 2–3%,2023 年以后才回到正常水平。
也就是说,FMP 缺少 2020 年以前死掉的大部分公司。那段时间的数据和 Kaggle 一样,有严重的幸存者偏差。
我考虑过三个办法:继续用 2004 年以后的数据并测量偏差有多大、换一个包含退市公司的付费数据源(比如学术界常用的 CRSP),或者只研究数据干净的年份。最后选了第三个:研究期定为 2021 年 1 月到 2026 年 9 月,共 68 个预测月份。
即使在这个区间里,2021 和 2022 年的退市率(1.8%、3.3%)仍然偏低,所以每个结果都会同时报告 2023 年以后的部分,看前两年的偏差会不会改变结论。
第三课:筛选条件本身也会制造幸存者偏差
第一次筛选股票池时,我设了几条看起来很合理的规则:国家必须是美国、必须有 CIK(证监会给每家公司的唯一编号)。
结果发现,雷诺美国烟草、时代华纳、全食超市这些已经被收购的公司,资料里的“国家”一栏是空的;罗克韦尔柯林斯的国家被错标成了西班牙,CIK 也是空的。死掉的公司资料往往不完整,所以“必须标明是美国”这样的规则,会系统性地把它们删掉。我等于又亲手引入了一次幸存者偏差。
改成“已经停止交易的公司,国家为空也保留,CIK 从财报里补”之后,找回了 682 家公司。
第四课:一家公司不等于一个股票代码
下载完价格后,我发现有 974 家公司在不同时期用过不止一个股票代码:
| 情况 | 例子 |
|---|---|
| 改代码 | AmerisourceBergen 改名 Cencora,代码从 ABC 变成 COR |
| 反向并购 | ARCA biopharma(ABIO)变成了 Oruka Therapeutics(ORKA) |
| 同一家公司的不同股票 | 谷歌的 GOOGL 和 GOOG |
| 同一个价格挂在多个代码下 | Overstock 同时挂在 BBBY、BYON、OSTK 下,价格完全一样 |
如果按股票代码来算,Overstock 会被算 3 次;另外有 801 个看起来像“退市”的情况,其实只是换了代码。所以公司要用 CIK 来识别,每家公司每个月只保留一个代码。
保留哪一个?一开始我选“当月成交额最高的”,结果谷歌每隔几个月就在 GOOGL 和 GOOG 之间来回切换。后来改成:优先选数据持续到最晚的那个代码,其次选总成交额最高的,并且一直用它。SVB 的例子说明了为什么要这样选:
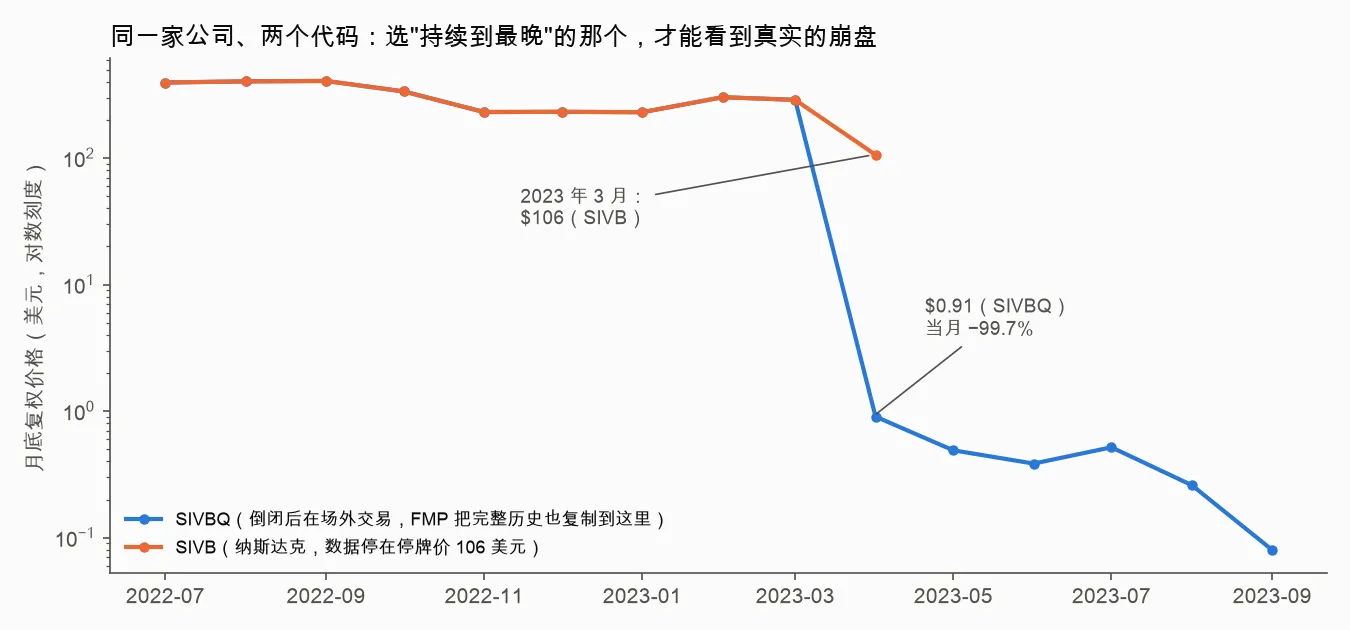
SVB 在纳斯达克的代码 SIVB,数据停在 2023 年 3 月停牌时的 106 美元。银行倒闭后,股票改在场外市场以 SIVBQ 交易,FMP 把完整的历史也复制给了这个代码,而且记录了月底 0.91 美元、当月 −99.7% 的真实崩盘。只有选对代码,这一跌才会出现在数据里。
但也有补不回来的:代码被别的公司重新使用后,原来的公司就消失了。孟山都的 MON 现在属于一家空壳公司,真正的 Bed Bath & Beyond 也不在了(BBBY 现在是 Beyond Inc. 的代码)。
第五课:财报“什么时候能看到”
这是解决“偷看未来”的关键。规则很简单:一份财报只能从证监会接收它之后的那个月底开始使用。
以摩根大通的 2025 年年报为例:
| 月底 | 能用的最新财报 | 原因 |
|---|---|---|
| 2026 年 1 月 | 2025 年第三季度 | 年报还没交 |
| 2026 年 2 月 | 2025 年全年 | 年报在 2 月 13 日交给证监会 |
基本面数字用的是最近四个季度加起来(TTM),每个季度更新一次,而不是一年才更新一次。研究期内 95% 的数据来自季报 TTM,中位数是 3 个月前的财报。
检查时发现了两个问题:
- 16% 的接收时间是假的:FMP 显示公司在季度结束当天就交了财报,这不可能,应该是缺少真实日期时填的占位值。如果照用,就会提前一个多月看到财报。现在这类日期一律改成证监会规定的最晚期限:季报在季度结束后 45 天,年报在 90 天。
- 和证监会的记录对照:我拿开发数据库里约 7,000 份 10-K 和 10-Q 的 EDGAR 提交日期来比,89% 在同一天。另外 10% 是 FMP 早一天,其中 96% 是在纽约时间下午 5:30 以后提交的。按证监会规定,这类文件的提交日期算作下一个工作日,但当晚就已经公开了,所以 FMP 记录的接收时间反而是真实的公开时间。相差超过一天的只有 0.3%。
还有一个解决不了的问题:FMP 给的是财报的最新版本。如果公司后来重述过以前的数字,我们看到的是重述后的。比如西部数据 2024 年分拆闪存业务后,年报按新的口径重新编制(营收 63 亿美元),而旧季报没有改,加起来是 95 亿。所以“什么时候能用”是准的,但“数字本身”不完全是当时公布的版本。
第六课:退市的那一跌
公司退市后就没有价格了,最后那一跌没有记录。学术上的通常做法(Shumway, 1997)是:被迫退市的,额外记一笔 −30% 的收益;被收购的不加,因为收购价通常已经反映在最后的股价里。
问题是 FMP 不告诉我们公司为什么退市。看了所有退市公司的数据后,发现它们明显分成两类:一类在最后几个月股价暴跌、或者跌到 1 美元以下;另一类是在接近高点时被收购,比如 Twitter 退市前 6 个月涨了 10%,动视暴雪涨了 23%。
所以规则定为:最后 6 个月跌超过 50%,或者股价低于 1 美元,算被迫退市;其余算被收购。研究期内共有 1,686 次退市,28% 被判为被迫退市,平均每年约 6.5%,符合正常水平。
第七课:数据错误永远比想象的多
这一阶段遇到的数据错误:
- 有 112 家公司的复权价格超过 100 万美元一股,最离谱的是每股 4,455 亿美元;有的价格大到连 64 位整数都装不下。
- 有的股票“一个月涨 4 倍、下个月跌回去”,这是一次性的错误报价。
- 有的季度营收是负数。原因是 FMP 用“年报减去前三个季度”来推算第四季度,两者对不上时就算出了负数。
- 季报四个季度加起来,和年报相差超过 10% 的约占 6%,主要原因是前面提到的重述。
清洗后,大约 3,900 个公司-月份的收益被设为空值。这一轮最大的体会是:每换一种方式使用一列数据,都可能暴露出新的错误。
后来(第九篇时)又发现了一个,而且影响最大:FMP 季度数据里的“股价”,其实是按今天复权过的价格,股数却常常没有按后来的反向合股调整。反向合股是把很多股合成一股,比如 50 股合 1 股,复权价就要乘以 50。复权价乘以合股前的股数,市值就被放大了 50 倍。Hyzon 2021 年 10 月显示的市值是 610 亿美元,实际约 12 亿;Canoo 2022 年 11 月显示 1,700 亿,实际约 3.7 亿。同样的原因,表里的“股价”也是复权价,所以“股价不低于 1 美元”的过滤也用错了数字。
修法是下载每家公司的拆股历史,判断每个季度的股数调整过哪些后来的拆股(让股数在季度之间平滑变化),再把复权价换回当时的真实价格。修正后,约 1.2 万个公司-月份被排除,它们的真实股价其实低于 1 美元;10 亿美元以上的股票池每月少约 30 家,100 亿以上少约 6 家,离开的全是小公司。还有大约 50 个公司-月份的数据自相矛盾,用现有数据修不了。
第八课:新数据上的第一次样本外检验
最后得到的表:每月约 4,000 家可用的公司,68 个预测月份,包含死掉的公司,财报按公布时间对齐,收益包含分红和退市损失。用它先检验一下阶段一的结论:
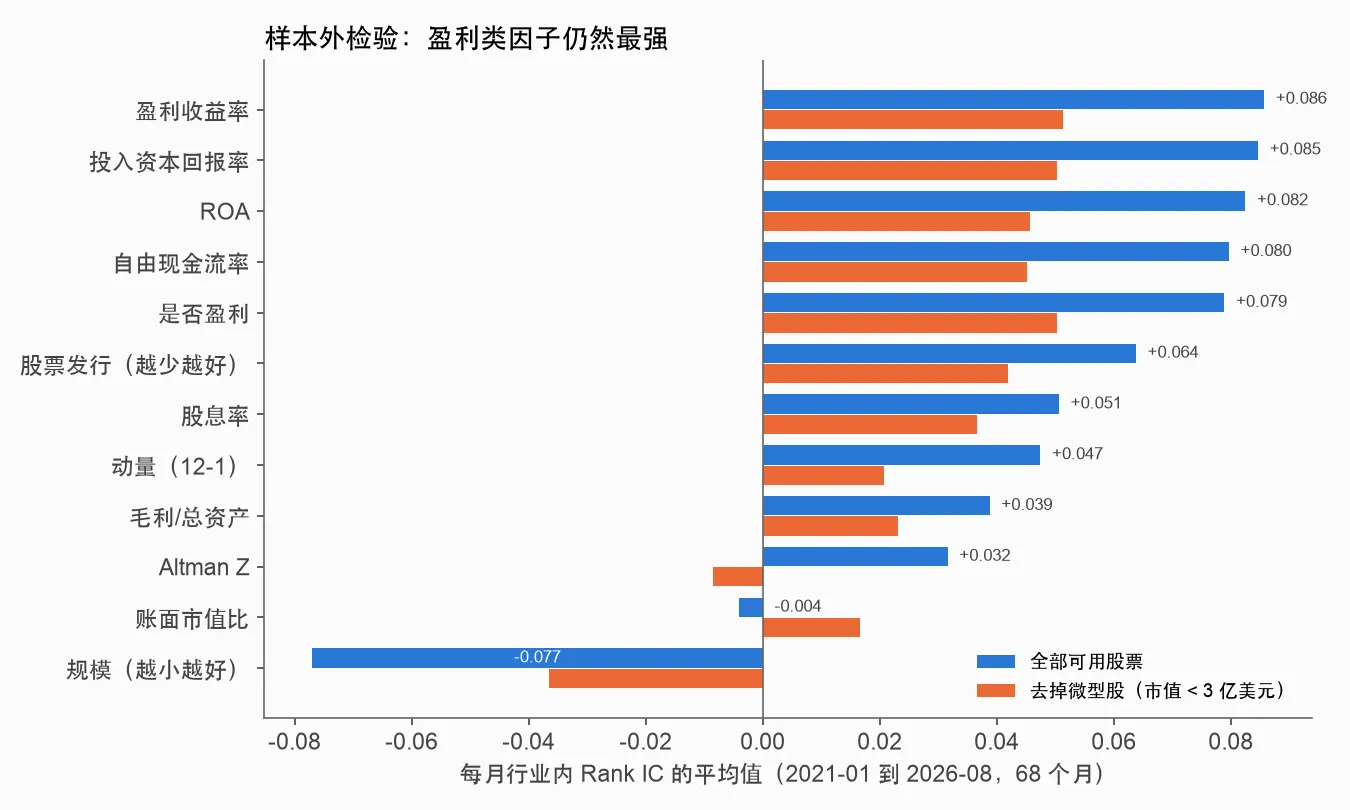
阶段一的主要结论成立:盈利类因子(投入资本回报率、ROA、盈利收益率、自由现金流率、是否盈利)的月度 IC 在 0.08 到 0.09 之间,76% 以上的月份为正;去掉微型股后仍然有约 0.05。月度 IC 天然比年度小,因为一个月的收益大部分是噪音。
按时期拆开看:
| 因子 | 2021–2022 | 2023–2026 |
|---|---|---|
| 投入资本回报率 | +0.096 | +0.078 |
| 是否盈利 | +0.096 | +0.069 |
| 动量(12-1) | +0.026 | +0.059 |
| Altman Z | −0.008 | +0.053 |
- 盈利类因子在两个时期都很强,2023 年以后略弱一些,但仍然是最强的一组。所以 2021–2022 年的轻微幸存者偏差,不会改变最重要的结论。
- 动量在月度数据上有效了(+0.047),而阶段一的年度数据根本测不出动量。
- Altman Z 不稳定:阶段一里它是最稳的因子之一,这里在 2021–2022 年是负的,去掉微型股后整体也是负的。
- 规模仍然是反的:大公司跑赢小公司,和阶段一一样。
需要注意的是,基本面数字变化很慢,相邻月份的 IC 是相关的,所以这些结果的 t 值都偏高。下一步会用 Newey-West 方法修正。
踩过的坑
- 限额是共用的:一开始按每分钟 250 次下载,差点挤占线上业务的额度。
- 流量统计显示为 0:每个公司资料只有约 1 KB,我在每次累加时都四舍五入到两位小数,小的增量全被舍掉了。好在真正用来判断上限的账本记的是整数字节。
- “6 行”不等于“6 个月”:计算“6 个月前的价格”时,我先用了往前数 6 行。中间如果缺了月份,就会取到更早的价格。改成按日历月份查找。
- 代码来回切换:按每月成交额选代码,导致谷歌在两个代码之间反复跳。
- 我的原计划是错的:一开始计划研究 2004–2026 年,直到算出每年的退市率,才发现前 16 年的数据不能用。任何数据集,先检查“死掉的公司在不在”。
局限和下一步
- 研究期只有约 5.7 年,只够判断夏普比率在 1 左右的策略。
- 2021–2022 年还有轻微的幸存者偏差。
- 财报数字是最新版本,不是当时公布的版本。
- 行业和交易所用的是今天的分类,FMP 没有历史记录。
- 代码被重新使用的公司(孟山都、Bed Bath & Beyond)补不回来。
下一步是价格类因子:12-1 动量、短期反转、低波动。并且会和 Kenneth French 教授公开的因子数据逐月对照,用学术界的标准答案来检查这份新数据和代码对不对。