股票评级研究笔记(三):六个因子,只有 ROIC 过线,而且有一部分是挑了大公司
第一个模型:六个经典因子各自单独评级,和随机评级比。只有 ROIC(营业利润 ÷ 投入资本)过了事先定的合格线。再查一步发现,它的成绩里有一部分只是因为偏向大公司;扣掉市值以后它仍然过线,但 2021 年以后几乎没有优势了。
这是股票评级研究笔记的第三篇。上一篇定下了评判标准:每个月,S 级(最可能跑赢 SPY 的 10%)一年后跑赢 SPY 的比例,要明显高过整个股票池(什么都不做是 43.8%)。这一篇做第一个模型:一个因子,能不能做到? 代码仍然由 Claude Code 编写,我负责提问、读代码和决定方向。
本文是学习记录,不构成任何投资建议。
为什么只试六个
我第一反应是问:以前在 quant-lab 里研究过 18 个因子,为什么这次只试 6 个?是 QC 给不了吗?
不是。研究数据库里有 119 个字段,18 个里有 17 个都能算。少试是故意的,原因是运气。上一篇量过:随机评级有约 2.8% 的机会碰巧过合格线。试 6 个因子,至少一个碰巧过线的概率约 16%;试 18 个,约 40%。试得越多,“有一个过了”越不值钱。
所以先挑最有理由的几个,在看结果之前写下来。以前的研究已经淘汰了一批(股息率、市销率、账面市值比这些在更长的历史里消失了;短期反转要每月大换血;规模本身不该进评级),剩下的每一类留一个代表:
| 因子 | 算法 | 类别 |
|---|---|---|
| 盈利收益率 | 最近 12 个月净利润 ÷ 市值 | 估值:以前最好的一个 |
| ROIC | 最近 12 个月营业利润 ÷ 投入资本 | 质量:赚钱的效率 |
| 毛利 / 资产 | 最近 12 个月毛利 ÷ 总资产 | 质量:学术上最有名的一个 |
| 财务健康评级 | Morningstar 的 A–F 评级 | 安全:避开要出事的公司 |
| 低波动 | 过去 12 个月股价波动率,越低越好 | 价格 |
| SUE | 最近一季净利润比去年同季多了多少,除以这个变化的历史波动 | 业绩新闻 |
都用财报字段自己算,不用 Morningstar 现成的比率(第一篇查出来,那些比率早年的日期提前了约两个月)。评级日还没申报的财报,当天当作不知道。
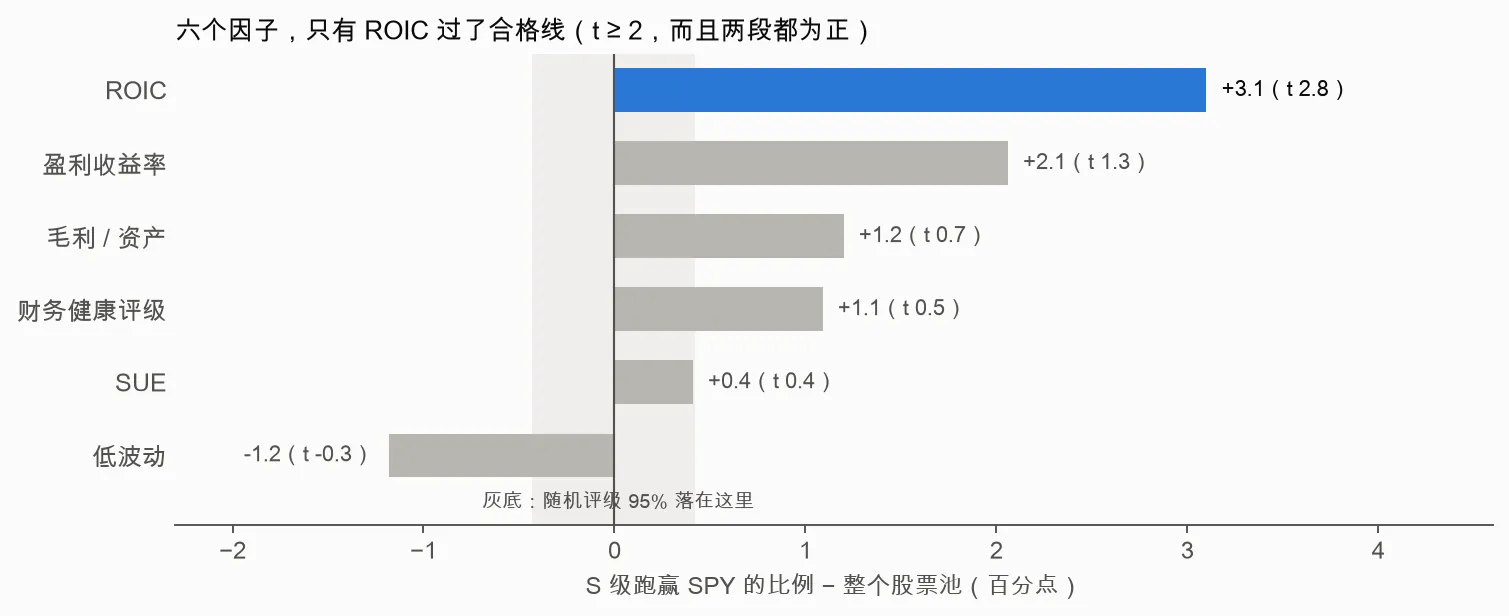
结果:只有 ROIC 过线
| 因子 | 主指标(百分点) | t | 2008–2020 | 2021 起 | 过线 |
|---|---|---|---|---|---|
| ROIC | +3.1 | 2.8 | +3.6 | +1.6 | 是 |
| 盈利收益率 | +2.1 | 1.3 | +1.1 | +4.9 | 否 |
| 毛利 / 资产 | +1.2 | 0.7 | +3.1 | −4.1 | 否 |
| 财务健康评级 | +1.1 | 0.5 | +1.9 | −0.9 | 否 |
| SUE | +0.4 | 0.4 | −1.0 | +4.3 | 否 |
| 低波动 | −1.2 | −0.3 | −1.1 | −1.4 | 否 |
主指标是“S 级跑赢 SPY 的比例减去整个股票池的比例”,合格线是主指标 t ≥ 2,而且 2008–2020、2021 年以后两段都为正。
几个没过的,各有各的样子:
- 盈利收益率:方向是对的,但 t 只有 1.3。更大的问题是它的 S 级(45.9%)还不如 A 级(46.6%):最便宜的那 10% 里,混着“便宜是因为要出事”的公司。
- 毛利 / 资产和 SUE:两段方向相反。前者 2021 年以后是负的,后者 2008–2020 年是负的。一个时代有效、另一个时代反过来,不能当模型用。(这里的 SUE 没有用分析师预期,和以前研究里那个“超出分析师预期”的 SUE 不是一回事。)
- 财务健康评级:D 级和 S 级跑赢的比例差不多,分不出好坏。
- 低波动:S 级反而低于股票池。最稳的那 10% 股票,常常跟不上 SPY。它擅长的其实是把 D 级挑出来(D 只有 39.1% 跑赢),不是挑出 S。
还有一个意外:以前用“下个月收益的相关性”排名,低波动和盈利类因子都很强;换成“一年后跑赢 SPY 的比例”这把尺子,排名就变了。换了目标,以前的冠军不一定还是冠军。
ROIC 的样子:更会挑出 D,而不是 S
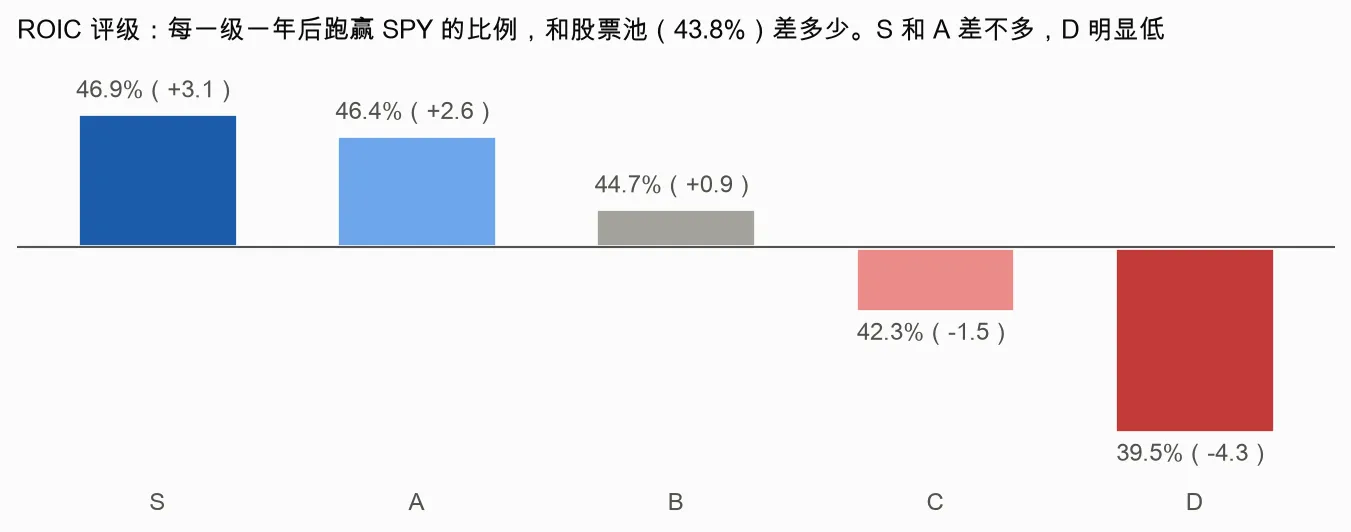
从 S 到 D 一级比一级低,这是好的形状。评级也很稳,每月只有 4% 的公司换级。
但细看,S(46.9%)和 A(46.4%)几乎一样,差距主要在另一头:D 级只有 39.5% 跑赢 SPY,比股票池低 4.3 个百分点。也就是说,ROIC 更擅长告诉你“别买哪些”,而不是“最该买哪个”。赚钱效率最低的公司,一年后大多跑输 SPY;赚钱效率最高的 10% 和次高的 20%,差别不大。
一个疑点:是不是只挑了大公司
成绩表里还有一列:S 级成交额的中位数是股票池的 2.7 倍。ROIC 的 S 级偏向大公司。
这是个问题,因为大公司本来就更常跑赢 SPY(SPY 是按市值加权的,巨头涨,它就涨)。如果 ROIC 只是“顺便挑了大公司”,那它的成绩就不算选股。
于是又做了一个检查,同样先写下判定再跑:
- 只挑大公司:按市值从大到小评级,当作参照。
- 市值中性的 ROIC:每个月先把股票池按市值切成 10 组,ROIC 只在大小相近的公司之间排名。这样 S 级里大公司和小公司的比例,和整个股票池一样。
- 判定:市值中性的 ROIC 如果还过合格线,就说明 ROIC 不只是挑了大公司。
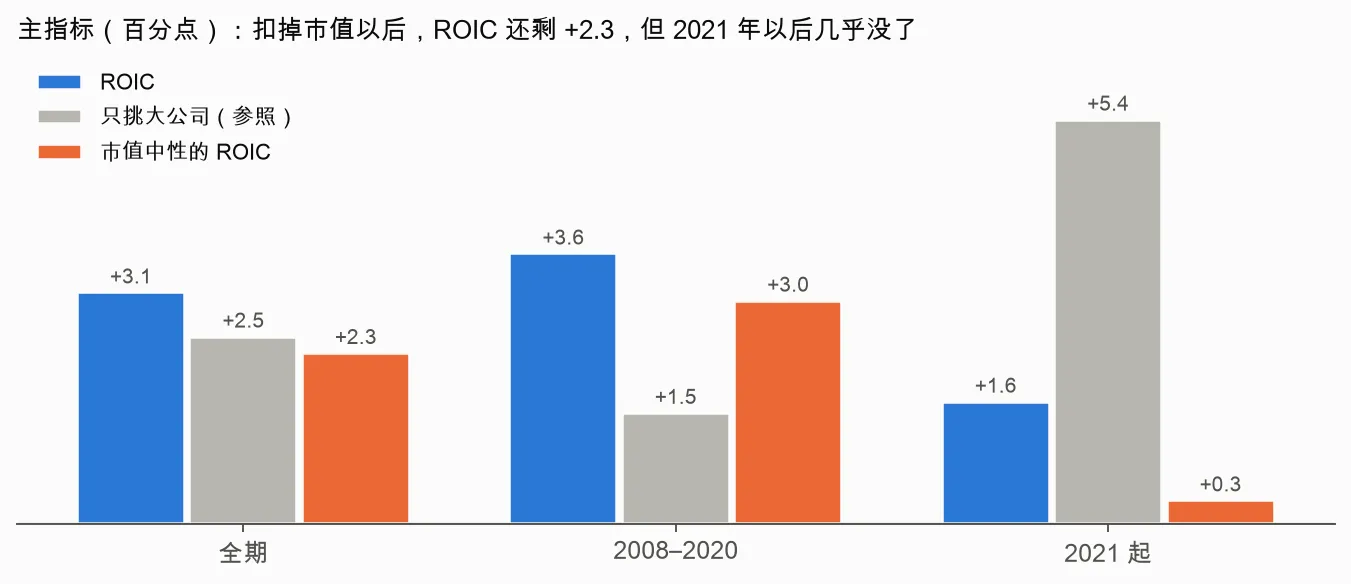
结果有三层:
- 只挑大公司能得 +2.5,但 t 只有 1.8,没过线,而且几乎全靠 2021 年以后(+5.4)。那几年少数巨头带着 SPY 涨,大公司更容易跟上;2009、2016、2020 年它大幅为负。
- 扣掉市值以后,ROIC 还剩 +2.3,t 2.4,两段都为正,过线。 所以 ROIC 原来的 +3.1 里,大约 +2.3 是它自己的,约 +0.8 来自偏向大公司。
- 但扣掉市值以后,2021 年以后只剩 +0.3,最近三年按年看都是负的。原始 ROIC 在 2021 年以后的 +1.6,有一大半是“挑了大公司”带来的。
那为什么还用它
按事先写好的规则,ROIC 就是第一个模型 model_v1:它是六个里唯一过线的,扣掉市值也还过线。规则是在看结果之前定的,结果出来就按规则走,不因为结果不完美就临时换标准。
但要说清楚它是什么:它是第一个跑赢 baseline 的模型,不是一个强模型。 优点是简单、稳定;S 级偏向大公司,对一般投资者来说也不是坏事。弱点是 S 不比 A 好,而且最近几年的优势很薄。真正没看过的检验,是上线以后实际发生的月份。
学到的几件事
- 少试几个,事先写下来。 试的因子越多,靠运气过线的机会越大。6 个是一个有理由的名单,不是全部能算的东西。
- 换了目标,就要重新排名。 在“下个月收益”上很强的低波动,在“一年后跑赢 SPY”上反而不行。
- 看成绩来自哪里。 一个过线的因子,可能只是悄悄偏向了某一类股票(这次是大公司)。把那一类扣掉再看一次,成绩就从 +3.1 变成了 +2.3。
- 挑出 D 和挑出 S 是两种本事。 ROIC、低波动都更会挑出要跑输的股票,而网站用户最关心的是 S。
- 规则先定,结果出来照规则走。 哪怕结果不完美,也比看了结果再改规则可信。
下一步有两件事:把 ROIC 部署上线,每天给股票打分(评级比例改成 10/20/40/20/10,输出格式要跟着改);然后做多因子模型,看能不能让 S 级真的比 A 级好。