股票评级研究笔记(四):S 为什么不比 A 好,找到的答案其实是一种风格
多因子没能让 S 级好过 A 级。把分数曲线画出来才看清:前 45% 是一层台阶,分数再高也不更常跑赢。在前 30% 里改按“利润稳定”重排,S 终于明显好过 A,过了事先定的合格线;但按年份拆开看,这个提升有很大一部分是押注防御风格,遇到高波动股领涨的大牛市就会输。
这是股票评级研究笔记的第四篇。上一篇的第一个模型 ROIC 过了合格线,但留下一个问题:S 级(分数前 10%)一年后跑赢 SPY 的比例,和 A 级(10%–30%)差不多。 对网站用户来说这很要紧:大家最关心的是 S。这一篇试了三步:多因子、诊断、换一种信号重排。最后 S 确实好过了 A,但拆开看以后,我对这个“好”的理解和一开始很不一样。代码仍然由 Claude Code 编写,我负责提问、读代码和决定方向。
本文是学习记录,不构成任何投资建议。
第一步:多因子,几乎不加分
最自然的想法是把 ROIC 和别的因子合起来。和上一篇一样,先把候选和规则写下来再跑,只试三种有理由的组合:
- ROIC + 盈利收益率:“好公司又便宜”。盈利收益率单独排第二。
- ROIC + 财务健康:把“看着赚钱、其实要出事”的公司往下压,想解决的正是 S 不比 A 好。
- 三个都用。
判定也比“主指标看起来更高”严格:每个月在同一批公司上直接比,组合减 ROIC 的差平均要大于 0,而且 t ≥ 2,才算明显更好。
结果三种组合的主指标都在 +3.1 到 +3.4 之间,和 ROIC 的 +3.1 差不多;按月直接比,只多 0.04–0.25 个百分点,t 只有 0.0–0.2。原因不复杂:盈利收益率和 ROIC 的百分位相关 0.61,赚钱多的公司往往也显得“便宜”,两个因子挑的大半是同一批公司。财务健康和它们几乎无关,但它单独本来就很弱。
S 还是不比 A 好:三种组合的 S − A 只有 0.1–0.7 个百分点。
这里有一个要老实记下的选择。按规则,没有组合明显好过 ROIC,应该不换。但 ROIC + 盈利收益率总成绩和 ROIC 打平,而 2021 年以后明显更好(主指标 +3.7 对 +1.6),也更不依赖大公司。我选了它作为 v2,现在线上用的就是它。这是平手时的产品判断,不是数据证明它更好:在 12 个月的目标下,2021 年以后只有大约 5 个互不重叠的年份,多出来的 2 个百分点和运气分不开。
弯路:一直在调分数,没看分数在哪里有用
到这里我其实已经绕了一段路。从第一个模型开始,S 不比 A 好就一直在,我的反应一直是“换个因子、再合一个”。但合格线看的是 S 整体比股票池好多少,它说明分数有用,却不说明分数在哪个位置有用。
所以下一步不再做新模型,只做诊断。事先写下三种可能,每种指向不同的下一步:
- 分数的顶端没有信息:分数越高越常跑赢,但到了前面某处就平了。那再怎么调 ROIC 和盈利收益率都分不出 S 和 A。
- 某类公司把 S 拉低:分数最高的那批里混着一类常输的公司。
- 只是某些年份的问题:有的年份 S 好、有的年份 A 好,平均下来打平。
把分数曲线画出来:是一层台阶
把 v2 的分数从高到低每 5% 切一档,看每一档一年后跑赢 SPY 的比例:
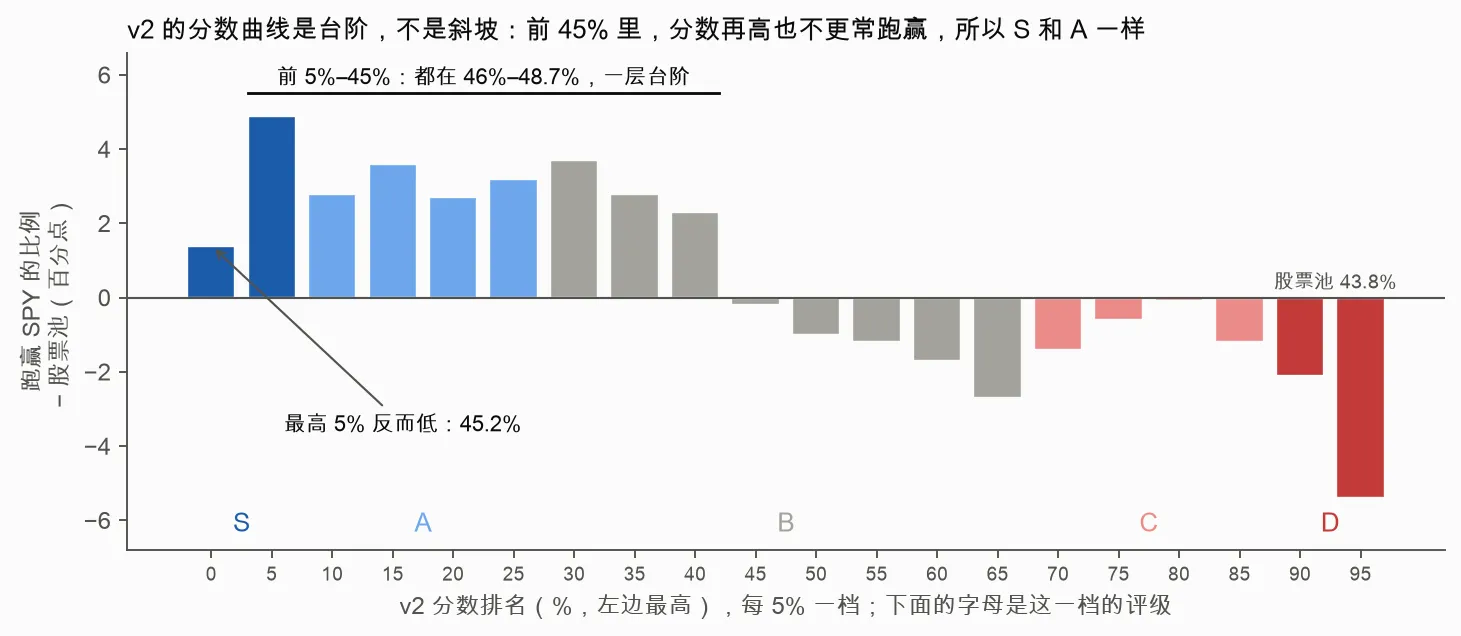
形状一眼就清楚:前 5%–45% 的 8 档都在 46%–48.7%,45%–90% 都在 41%–44%,最后 10% 才掉下去。 它不是一条从左到右往下走的斜坡,而是两层台阶。S(前 10%)和 A(10%–30%)站在同一层上,所以一样。这就是可能 ①。
另外两个发现:
- 最高的 5% 反而更差:45.2%,比紧挨着的 5%–10% 那档低 3.5 个百分点(t −2.7)。单独 ROIC 的最高 5% 不掉,掉下来的是两个因子都极高的公司。和 A 比,S 里的公司过去一年股价基本没涨(12-1 动量 0.2% 对 8.3%),利润却刚涨了一截(同比 +29% 对 +18%),波动更大,能源和原材料占 17%(A 是 11%,整个股票池 9%)。“利润冲高、股价没动,所以显得又赚钱又便宜”,这是典型的周期高峰,只看过去 12 个月利润的因子看不出来。这是可能 ② 的一部分。
- 不是年份的问题:S − A 在 2008–2020 和 2021 年以后都是 +0.06。可能 ③ 排除。
还有一个更根本的数:在前 30% 里面,按 ROIC 高低再分三组,高的一组只多跑赢 0.5 个百分点(t 0.3);盈利收益率甚至是负的。这两个因子在全体公司里有用(t 3.7 和 2.7),在前 30% 里分不出赢家。 所以诊断的结论是:要让 S 好过 A,得在前 30% 里换一种不同类型的信号来排,而不是再加一个类似的财报比率。
换一种信号重排:利润稳定过线
诊断里,前 30% 内部差距最大的两个特征是波动(高波动的少跑赢 5.4 个百分点)和利润同比(利润刚暴涨的少跑赢 3.3 个百分点)。于是有了三个候选:
- 低波动:过去 12 个月股价波动越小越靠前。
- 利润稳定:最近 8 个季度净利润越平稳越靠前(标准差 ÷ 绝对值的平均,越小越好)。
- 两个都用。
做法只动前 30%:v2 的 S + A 还是同一批公司,在它们内部按新信号重新排,前三分之一是 S,其余是 A;B、C、D 和 v2 完全一样。合格线事先写好:S − A 大于 0,t ≥ 2,2008–2020 和 2021 年以后两段都为正。
| 排法 | S / A 跑赢 SPY | S − A | t | 是否过线 |
|---|---|---|---|---|
| v2(原样) | 46.9% / 46.9% | +0.06 | 0.1 | — |
| 低波动 | 49.2% / 45.8% | +3.42 | 1.4 | 否 |
| 利润稳定 | 48.8% / 45.9% | +2.89 | 2.09 | 是 |
| 两个都用 | 49.5% / 45.6% | +3.83 | 1.8 | 否 |
三种重排都让 S 明显好过了 A,但只有利润稳定的 t 够了。它成了 v3。整体主指标也从 +3.1 升到 +5.0(t 4.0)。S 的样子变了很多:来自市值最大 20% 的比例从 27% 升到 42%,能源加原材料从 17% 降到 8%。
如果到这里就停,这会是一篇“终于找到答案”的文章。
但它其实是一种风格
看完平均以后,又按年份拆开看了一次:
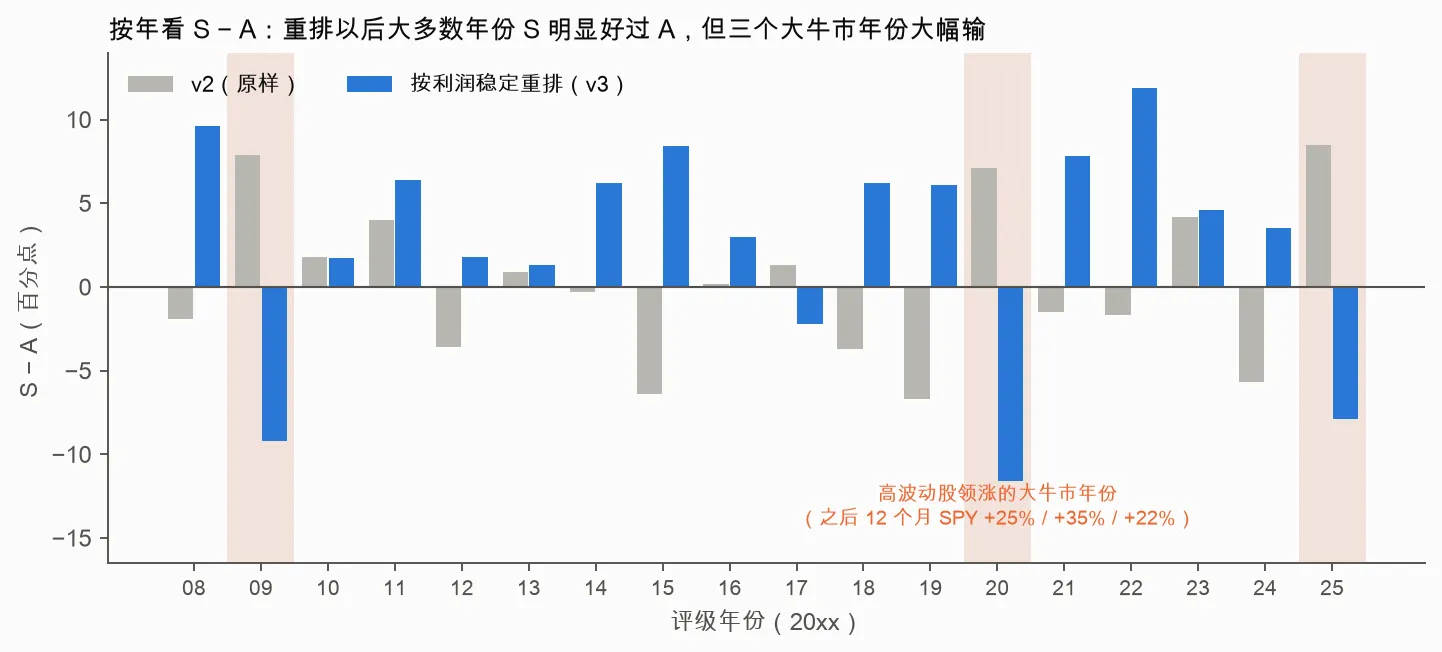
大多数年份,重排后的 S 都明显好过 A。但 2009、2020、2025 三年,S 大幅输给 A。这三年有一个共同点:之后 12 个月是高波动股票领涨的大牛市(SPY 分别涨了 25%、35%、22%)。
为了确认,我造了一个“高波动股表现”的指标:每个评级月之后的 12 个月里,整个股票池里波动最高的三分之一减最低的三分之一,跑赢 SPY 的比例差多少。然后按它把 211 个评级月份分成三组:
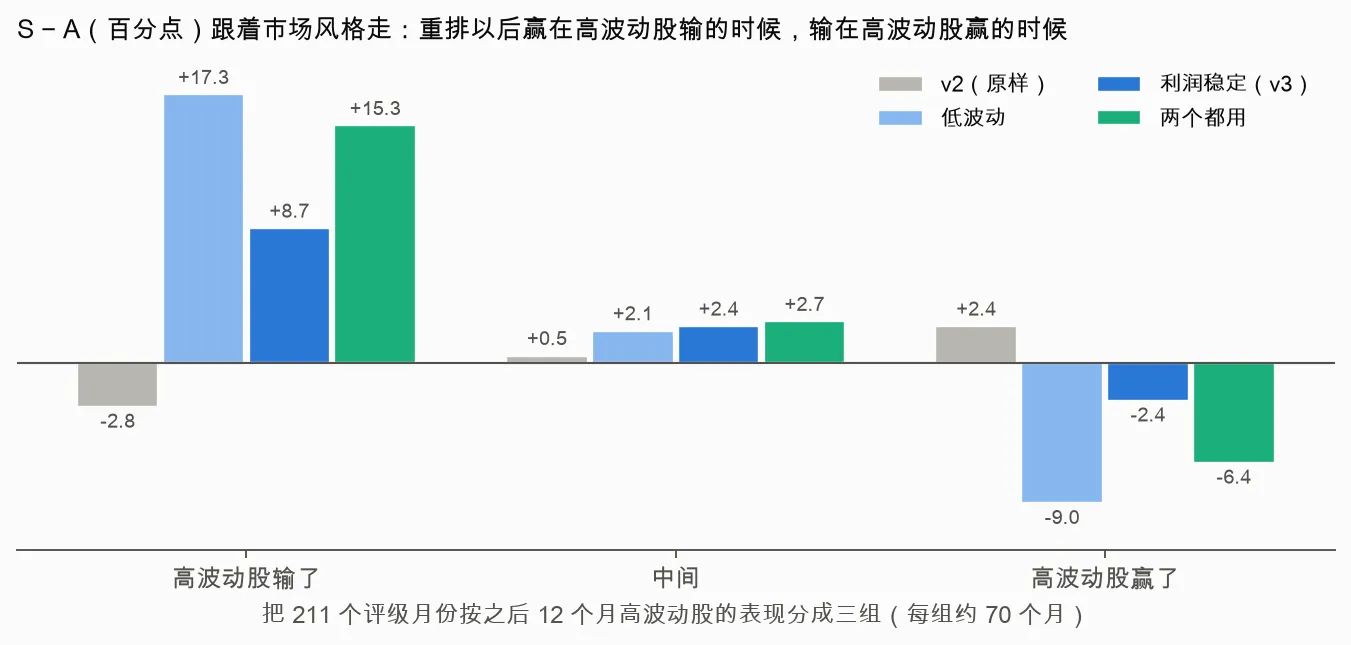
图很清楚:重排以后,S − A 赢在高波动股输的时候,输在高波动股赢的时候。 低波动排法最极端(+17.3 对 −9.0),利润稳定最温和(+8.7 对 −2.4)。逐月算相关,利润稳定的 S − A 和这个指标的相关是 −0.61,低波动是 −0.84。原来的 v2 正好相反(+0.38):它的 S 偏高波动的周期股,正负抵消,所以平均是 0。
还有两个数让我对这个结果的理解更准确:
- S 本身其实很稳,大起大落的是 A。 以两个都用的排法为例,S 跑赢 SPY 的比例在那三个坏年份是 48.1%,其他年份 49.7%,差不多;A 在坏年份是 61.9%,其他年份只有 42.8%。重排做的事,是把稳的公司放进 S,把波动大的留在 A。
- 这种年份事先看不出来。 S − A 和评级前 6 个月 SPY 的涨跌几乎无关(相关 −0.01),和之后 12 个月的涨幅却是 −0.63。如果去掉那三年,S − A 是 +5.1(t 5.3),看起来好得多,但没有人能提前知道哪一年是这种年份,这个数不能当真。
所以更准确的说法是:v3 的 S 是一批稳定、偏大、偏防御的公司。平常年份和下跌年份它明显好过 A;遇到高波动股领涨的大牛市,它会落后 A 几个百分点。 这是它的特点,不是坏了。
为什么还是用它
按事先写的规则,利润稳定是唯一过线的,就选它,不因为看到风格问题临时改标准。而且在三种重排里,它的风格押注最轻:大牛市里只输 2.4 个百分点,S 也没有像低波动那样过度集中在最大的公司上。
但证据比前几步弱,要说清楚:
- 这两个信号是看了诊断那份数据以后才挑的,同样是 2008–2025,没有没看过的年份。
- 2008–2025 只有大约 17 个互不重叠的年份,而 S − A 跟着市场风格大幅摆动,几个年份就能左右平均。
- 真正的检验是上线以后的月份。 v3 会先作为“影子模型”和 v2 并行跑,结果不上网站,等积累一段时间再决定要不要换。
学到的几件事
- 过了合格线,不等于分数在每个位置都有用。 主指标只看 S 整体;要看分数曲线的形状,才知道问题出在哪里。这次把曲线画出来以后,问题一下子就清楚了。
- 类似的信号合起来加不出信息。 几个经典财报因子挑的公司高度重叠,等权合起来很难超过其中最好的那个。要换一种类型的信号。
- 平手时的选择要写明是判断。 v2 是按偏好选的,把这一点写下来,以后才不会把它当成已经证明过的事。
- 只看平均,会把风格押注当成选股能力。 S − A 跟着市场风格大幅摆动时,要把它和风格放在一起看,才知道赢的到底是什么。
- 看了数据才提出的假设,结果要打折扣。 规则可以事先写好,但信号是从同一份数据里挑出来的,真正的检验只能留给以后。
下一步是把 v3 部署成影子模型,每天和 v2 一起评级;同时数据库改成每月自动更新,v3 用到的“利润稳定”就从那里读。