量化选股学习笔记(五):用 Ken French 的因子“对答案”
用自己搭的数据,按学术界的标准方法重新构建 Fama-French 因子和动量因子,再逐月和 Ken French 公开的结果对比。第一次对答案只有 0.167,修完数据、对齐口径后全部在 0.93 以上。顺便用日线数据研究了低波动和彩票效应。
这是我学习量化选股的第五篇笔记。上一篇用 FMP 的 API 重建了一张月度股票数据表,这一篇要回答一个问题:这张表到底对不对?代码仍然由 Claude Code 编写,我负责提问、读代码和决定方向。
本文是学习记录,不构成任何投资建议。
2026-10-23 更新:做到第九篇时发现市值数据有一个错误(见第四篇第七课的最后),修正后重跑了全部结果,本文的数字和图已经更新。
为什么要“对答案”
上一篇的检查都是局部的:苹果的股价对不对、摩根大通的财报日期对不对。但几十万行数据里,有没有系统性的错误,局部检查是看不出来的。
好在有一份现成的“标准答案”。达特茅斯大学的 Kenneth French 教授(Fama-French 因子模型的作者之一)在学校网站上免费公开了一批因子的月收益,用的是学术界最权威的两个付费数据库:CRSP(股价)和 Compustat(财报),而且都包含退市公司。
做法很简单:用我们自己的数据,按 French 公开的方法重新算一遍同样的因子,然后逐月比较。如果两边每个月的涨跌高度一致,说明数据和代码基本可信;如果对不上,就说明哪里有问题。
第一课:学术界怎么“造”一个因子
前几篇一直用 Rank IC 来衡量因子(因子排名和下月收益的相关性)。学术界更常用的方法,是把因子变成一个投资组合的月收益。以 French 的动量因子为例:
- 每月月底,以纽交所股票的市值中位数为界,把所有股票分成大、小两组。
- 再按过去 12 个月的涨幅(跳过最近 1 个月),以纽交所股票的第 30 和第 70 百分位为界,分成低、中、高三组。
- 这样得到 2 × 3 = 6 个组合,每个组合按市值加权,持有一个月。
- 动量因子 = 两个“高”组合的平均收益 − 两个“低”组合的平均收益。
为什么分界线只用纽交所的股票?因为纳斯达克有大量的小公司,如果用全部股票的中位数,很多其实很小的公司会被划进“大”组。我们的数据里,用纽交所的分界线,只有 27% 的股票算“大”;用全部股票,则有 50%。
这样做出来的是一条每月收益的时间序列,可以直接和 French 的序列比较。
第二课:第一次对答案,0.167
最简单的是市场因子:所有股票按市值加权的月收益,减去无风险利率。这本来应该几乎完全一致,结果第一次算出来的相关系数只有 0.167,有一个月和 French 差了 58.7 个百分点。
查下来,是一只场外交易的仙股 CLIS:数据里它的市值是 210 万亿美元,是整个美股的 4 倍多。按市值加权时,它一家在 2021 年 10 月占了“市场”的 78.5%。类似的还有一批:BTDG 6 万亿、TNXP 3.7 万亿,还有一只反复反向拆股的股票,算出来的市值是 6,600 万亿。(反复合股其实指向一个更普遍的错误,要到第九篇才发现,见第四篇的更新。)
为什么上一篇的检查没发现?上一篇用的是 Rank IC,只看排名。一只股票市值错了,最多是排名不对,几乎不影响结果:修复前后,因子的 IC 最多只变了 0.003。但按市值加权,会把一个错误放大成灾难。同一份数据,换一种用法,就会暴露出新的错误。
修复规则来自一个简单的观察:真实的大公司交易很活跃。苹果每月的成交额约占市值的 5%,连很少交易的伯克希尔也有 0.5%,而 CLIS 只有 0.0000002%。所以规则是:市值超过 100 亿美元、但当月成交额不到市值 0.2% 的,市值就当作不可靠。修复后,市场因子的相关系数是 0.999。
第三课:一个占位编号,删掉了 300 家公司
动量因子的代码有一个手算核对:随机挑一家公司,用股价手工算一遍动量,和程序结果比较。结果挑中的公司,CIK(证监会给每家公司的编号)是 0000000000。
这不是真的编号,而是数据缺失时填的占位值。一查发现,大约 300 个股票代码都用了这个占位值。上一篇为了避免重复计算,规定“每家公司(按 CIK)每月只保留一个股票代码”,于是这 300 家公司被当成了同一家,只剩一个代码,另外约 300 家被悄悄删掉了。
修复后,没有真实 CIK 的代码各自独立编号;破产后改用 Q 结尾代码的公司(比如 Ebix 从 EBIX 变成 EBIXQ),合并回原来的公司。
第四课:口径往往比数据更重要
数据错误修完之后,价值、盈利、投资三个因子还是对不上:
| 因子 | 第一次 | 原因 | 修正后 |
|---|---|---|---|
| 盈利 RMW | 0.738 | Compustat 的销售及管理费用(SG&A)包含研发,FMP 把研发单独列出。研发多的科技和生物医药公司,在我们的算法里显得“很赚钱” | 0.937 |
| 投资 CMA | 0.822 | French 每年 6 月用上一财年的年报排序,我们用的是 6 月时最新的季报 | 0.966 |
| 价值 HML | 0.924 | 同样是时间口径 | 0.975 |
| 规模 SMB | 0.898 | French 的 SMB 是三组排序的平均,我们只做了一组 | 0.985 |
我们的样本里有 40% 的公司有研发支出,所以一个科目的口径差异,就能让结果差这么多。数据本身没问题时,复现别人结果的剩余差距,大多来自定义。名字一样的变量(SG&A、资产增长),在不同数据源里可能是不同的东西。
最终的对照结果:
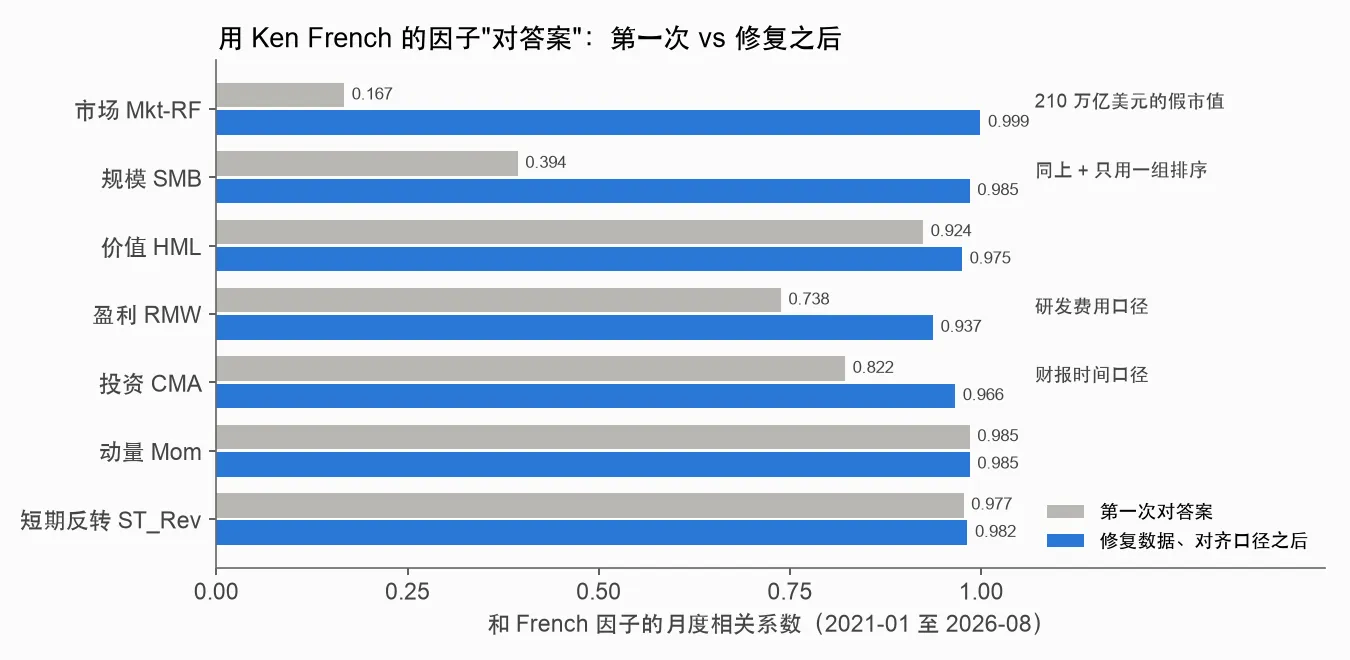
所有因子都在 0.93 以上。我原本预测财报类因子(价值、盈利、投资)会对得最差,在 0.7 到 0.9 之间,实际都超过了 0.93。这说明上一篇的财报数据,以及“财报公布之后才能用”的处理,都和学术界的标准数据库一致。
还有一点要说明:如果改成每月用最新的季报重新排序,和 French 的相关性会低一些(0.70 到 0.90)。这不是错误,而是一个更快、更新的不同信号。它预测得是不是更好,留到下一步研究。
第五课:动量和反转,对得上,但这几年没赚钱
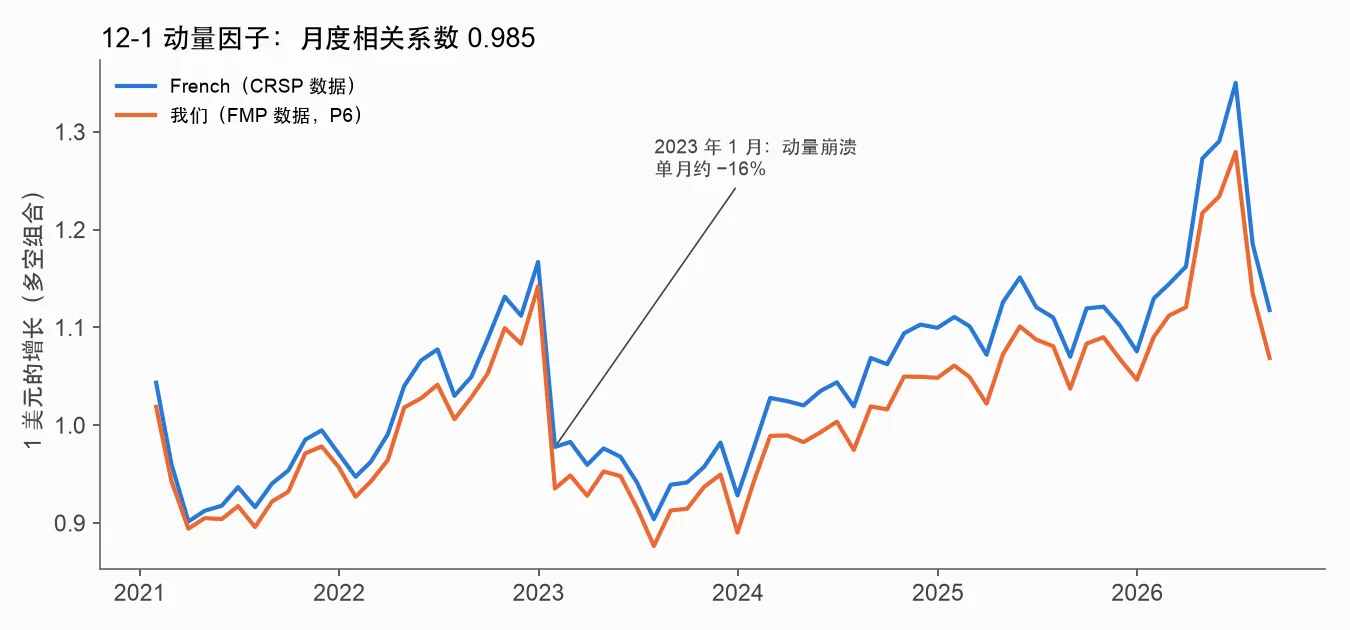
动量因子和 French 的相关系数是 0.985,短期反转因子是 0.982。动量最依赖“跌得最惨的股票”的真实收益,所以这也说明价格数据和退市处理基本正确。
但在 2021–2026 年,这两个经典因子都没有赚到钱:
| French 的月均收益 | t 值 | |
|---|---|---|
| 动量 | +0.25% | 0.5 |
| 短期反转 | −0.45% | −1.1 |
- 2023 年 1 月,动量单月亏了约 16%,是一次典型的“动量崩溃”。2022 年熊市里跌得最惨的股票,在市场转向时反弹最猛,而动量策略做空的正是它们。Daniel 和 Moskowitz(2016)专门研究过这种现象:熊市之后的反弹,是动量策略最危险的时候。
- 短期反转方向反了:上个月跌的股票接着跌,没有反弹。Jegadeesh(1990)发现的这个效应,近年在大公司里已经很弱,而 French 的因子按市值加权,主要反映的就是大公司。
第六课:日线数据里的新信号,低波动和彩票效应
阶段一只有年度数据,做不了需要日线的信号。这次用日线价格算了两个:
| 信号 | 定义 | 学术来源 |
|---|---|---|
| 低波动 | 过去 12 个月日收益率的标准差,越低越好 | Ang 等(2006);Frazzini 和 Pedersen(2014) |
| 低“单日最大涨幅” | 上个月涨得最多的一天,越低越好 | Bali、Cakici 和 Whitelaw(2011) |
结果:
| 信号 | 月度 IC | t 值 | 去掉微型股 | 只看赚钱的公司 |
|---|---|---|---|---|
| 低波动 | +0.101 | 5.6 | +0.057 | +0.035(t 1.9) |
| 低“单日最大涨幅” | +0.086 | 5.6 | +0.048 | +0.033(t 2.0) |
| 动量 | +0.047 | 3.5 | +0.021 | +0.020 |
| 投入资本回报率(对比) | +0.085 | 7.3 | +0.050 | +0.018 |
低波动是整个研究里最强的单一信号:不管去不去掉微型股,它的 IC 都比所有盈利指标高。波动小的股票反而表现更好,这就是学术上的“低波动异象”:承担更大的波动,并没有换来更高的收益。
“单日最大涨幅”代表的是彩票效应:投资者喜欢“可能一天暴涨”的股票,愿意为它付高价,结果这类股票之后表现更差。这和第三篇的发现一脉相承:最差的那一组股票像一堆彩票。
第七课:预测力 vs 独立性
第三篇学到的最重要的一课是:多个因子合在一起的效果,取决于它们之间有多不相关。所以不只要看一个因子预测得准不准,还要看它是不是在讲一个“不同的故事”:
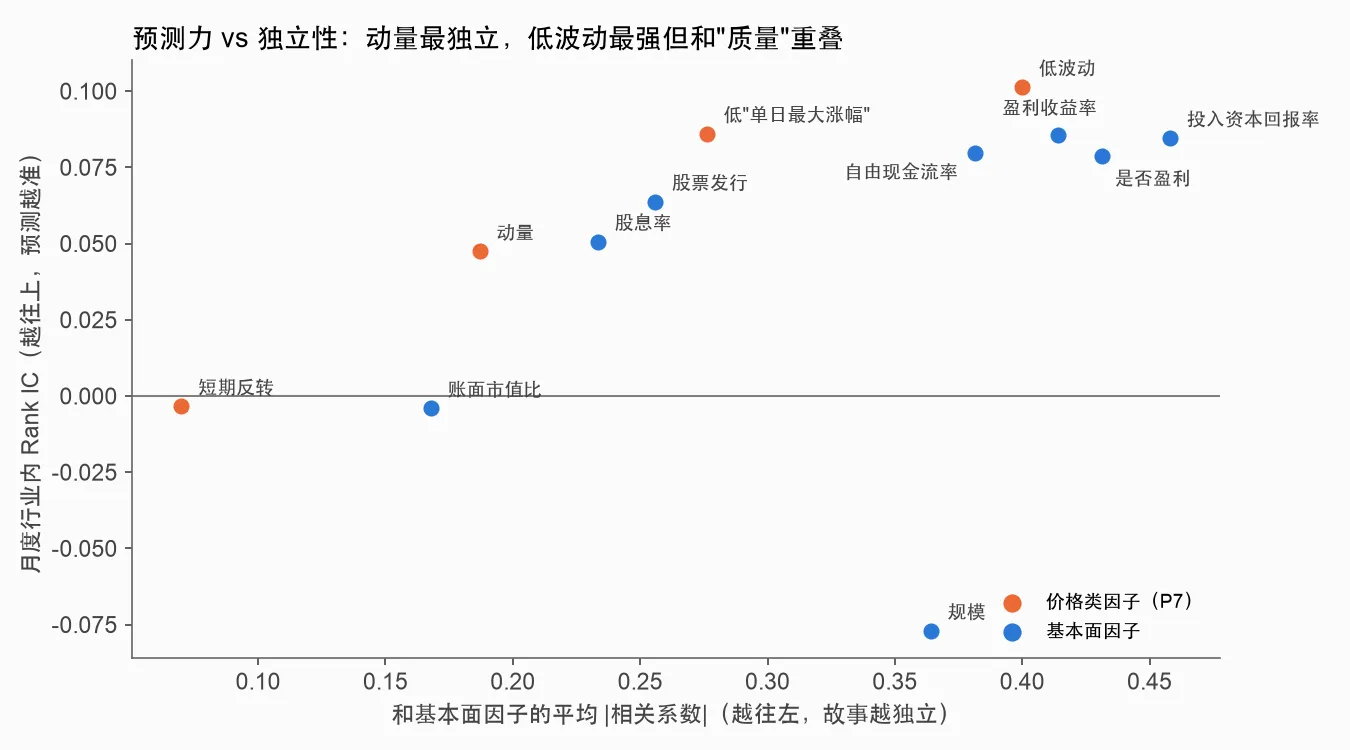
横轴是和基本面因子的平均相关系数(越往左越独立),纵轴是预测力:
- 动量是最独立的故事:和基本面因子的平均相关系数只有 0.19(基本面因子之间是 0.34)。它偏向盈利的公司(+0.20),远离便宜的价值股(−0.31):过去的赢家,很少是价值股。
- 低波动预测最强,但和“质量”重叠:平均相关系数 0.40。波动小的公司大多规模大(和“越小越好”的规模得分相关系数是 −0.49)、盈利好(+0.48)。不过在只看赚钱公司时,它的 IC 仍然最大,说明除了“赚不赚钱”之外,它还提供了一些额外的信息。
- 短期反转很独立,但没有预测力,加进来没有意义。
和学界的对照
- Fama 和 French(2015)的五因子模型(市场、规模、价值、盈利、投资),我们全部复现到了 0.93 以上。
- 动量(Jegadeesh 和 Titman,1993)复现到 0.985;2023 年 1 月的动量崩溃,和 Daniel 和 Moskowitz(2016)描述的熊市反弹模式一致。
- 低波动异象(Ang 等,2006)和彩票效应(Bali 等,2011)在 2021–2026 年依然存在,而且在大公司里也成立。
- 短期反转(Jegadeesh,1990)在这段时间失效,和近年的文献一致。
踩过的坑
- Rank IC 会掩盖数据错误:210 万亿美元的假市值,在 Rank IC 里几乎看不出来,按市值加权才暴露。
- 占位值会被当成真值:CIK 0000000000 让 300 家公司合并成了一家。几乎每个字段都可能有占位值:上一篇是财报日期,这一篇是公司编号。
- 同名的科目,口径不同:SG&A 是否包含研发,让一个因子的相关系数从 0.74 变成 0.93。
- 并列排名的假信号又出现了:在“只看赚钱的公司”时,“是否盈利”这个因子全部等于 1,并列的排名随组的大小变化,算出了 t 值 110 的假信号。这个问题第二篇就遇到过,这次在另一段代码里又出现了一次。
- 我的预测偏保守:我以为财报类因子最多对到 0.9,实际都超过了 0.93。
下一步
数据已经验证过了,下一步是真正的研究:在这张月度数据上重做阶段一的多因子合成和回测,并公平地比较树模型(LightGBM)和线性模型。这次有 68 个月、每月 4,000 多家公司,还有动量、低波动这些新信号,机器学习也许终于有了发挥的空间。